

🚀
GUIDE GRATUIT
RFP Chatbot : Ne partez pas d'une page blanche
Un mode d'emploi pensé pour les métiers avec un guide pas à pas pour rédiger chaque section de votre appel d'offres.
Méthodologie guidée : Quoi écrire dans chaque chapitre (Contexte, Fonctionnel, Tech)
Concepts clés décryptés : RAG, LLM, Base de connaissance
Modèles inclus : Structures prêtes à l'emploi pour vos cas d'usage
👉 Télécharger le guide
Le « taux de résolution chatbot » affiché dans la plupart des tableaux de bord mesure en réalité l’automatisation : la part des conversations terminées sans transfert vers un conseiller. Il ne dit pas si la demande du client a été traitée.
Selon la façon de le calculer, le même bot, sur les mêmes conversations, affiche 33 % ou 50 %. Intercom vient d’en faire la démonstration sur ses propres chiffres. Voici les trois chiffres à ne pas confondre, et comment obtenir un taux de résolution que vous pouvez défendre devant votre direction.
Imaginez que votre chatbot affiche 85 % de taux de résolution, alors que vos conseillers reçoivent toujours des « le bot ne m’a pas aidé ». Personne au comité de direction ne sait vraiment ce que ce 85 % mesure. Le problème ne vient pas du bot, mais de la définition du chiffre.
L’essentiel
Déflexion, automatisation et résolution sont trois chiffres différents. Seul le taux de résolution dit si la demande du client a été traitée.
Le marché converge vers une résolution vérifiée par une IA. Intercom a changé son dénominateur en juillet 2026 (33 % → 50 % sur son exemple), Zendesk ne compte que des « Verified Resolutions » depuis mai 2026.
Un vrai taux de résolution se mesure en lisant chaque conversation. Une IA distincte du bot relit 100 % des conversations terminées et rend un verdict justifié.
Votre premier chiffre sera autour de 40 à 50 %. C’est un point de départ, pas une note. Les bots suivis avec cette mesure se situent entre 50 et 85 % de résolution vérifiée.
Un taux de résolution fiable est auditable : vous pouvez ouvrir la conversation qui se trouve derrière le pourcentage.
Déflexion, automatisation et résolution mesurent trois choses différentes
Trois indicateurs se présentent comme « le taux de résolution » d’un chatbot, mais un seul dit si la demande du client a été traitée. La déflexion et l’automatisation comptent des conversations sans transfert, même quand le client est reparti sans réponse. L’écart entre eux se compte en dizaines de points.
Le taux de déflexion
Ce qu’il compte : les conversations qui n’ont jamais atteint un humain.
Ce qu’il rate : le client qui a abandonné, furieux, est compté comme « déflecté ».
Le taux d’automatisation (ou containment)
Ce qu’il compte : les conversations restées dans le canal du bot, sans transfert.
Ce qu’il rate : il ne dit pas si le bot a répondu à la question.
Le taux de résolution
Ce qu’il compte : les conversations où la demande du client a été traitée.
Ce qu’il rate : rien, à condition de le mesurer réellement.
Définition. Le taux de résolution d’un chatbot est la part des conversations où la demande exprimée par l’utilisateur a été effectivement traitée. Elle peut l’être par une réponse directe, par une redirection valide ou par une escalade correctement gérée, c’est-à-dire un transfert propre vers un conseiller.
La plupart des tableaux de bord affichent le taux d’automatisation sous le nom de taux de résolution. Une conversation sans transfert vers un conseiller y est comptée « résolue ».
L’utilisateur qui a posé sa question trois fois, obtenu trois réponses génériques, puis fermé la fenêtre est donc compté comme résolu. Celui qui a écrit « merci pour rien » l’est aussi.
L’écart n’est pas théorique. Selon une étude Gartner reprise par Maven AGI, l’IA déflecte plus de 45 % des demandes de service client, mais seulement 14 % environ aboutissent à une résolution complète en self-service. Il y a donc trente points d’écart entre « le bot a pris la conversation » et « le bot a réglé le problème ».
C’est aussi pour cette raison que les chiffres de 90 ou 95 % lus dans les brochures mesurent presque toujours l’automatisation. Ils ne sont pas faux : ils répondent à une autre question.
Les leaders du marché comptent désormais une résolution vérifiée
Deux changements récents montrent que le marché converge vers une résolution vérifiée, et non plus vers un compteur de non-transferts. Une résolution n’est plus comptée parce qu’il n’y a pas eu de transfert, mais parce qu’une lecture de la conversation l’a confirmée. Le dénominateur ne retient que les conversations où le bot avait vraiment une demande à traiter.
Intercom, juillet 2026. Intercom a modifié la définition des métriques de Fin. Les conversations où Fin était actif mais « n’a pas eu l’occasion de répondre » sortent du dénominateur. Sur l’exemple officiel : 1 000 conversations, 250 résolues. Ancien taux : 33 %. Nouveau taux : 50 %. Même bot, mêmes conversations, plus 17 points. Intercom a eu l’honnêteté de rappeler dans le même article que le taux d’automatisation, lui, ne bouge pas.
Zendesk, mai 2026. Depuis le 18 mai 2026, Zendesk ne facture et ne compte que les « Verified Resolutions » : l’agent IA a répondu, une étape de vérification par un modèle de langage a confirmé que le problème était réglé, et le client n’a pas contesté.
Si vous comparez des éditeurs en ce moment, posez-leur d’abord cette question : comment comptez-vous une résolution, et qui la vérifie ? Inscrivez ce critère dans votre cahier des charges, à côté de ceux de notre guide pour rédiger un appel d’offres chatbot IA.
Une IA distincte du bot relit chaque conversation terminée et rend un verdict
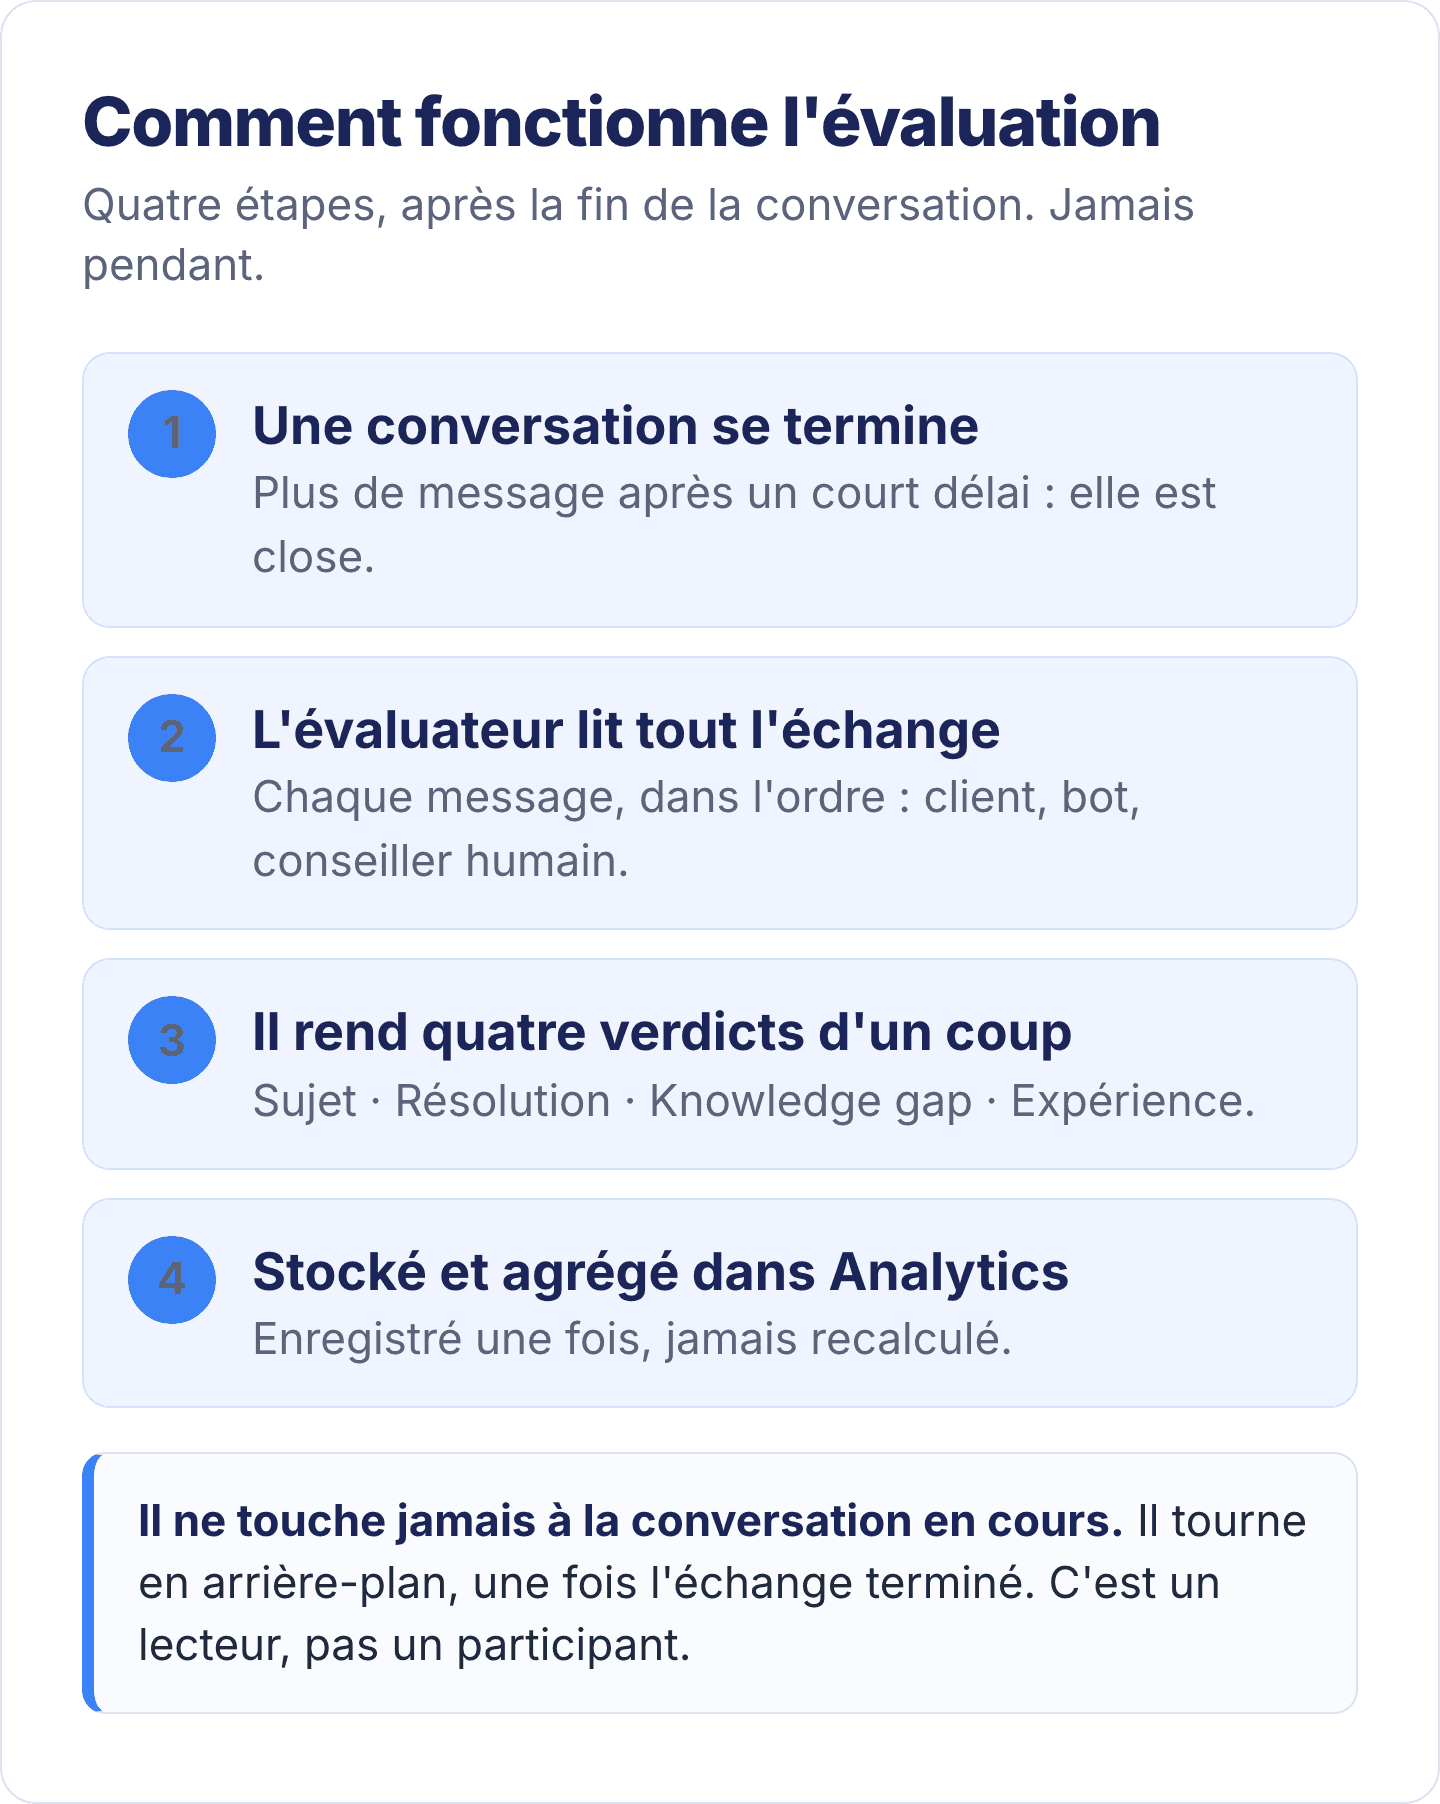
La seule façon fiable de savoir si une conversation a été résolue est de la lire. Sur 50 000 conversations par an, personne ne le fait : on le confie donc à une IA. Un modèle de langage, distinct de celui qui répond aux clients, relit chaque conversation terminée avec une grille de critères fixe et rend un verdict.
Ce principe s’appelle LLM as a judge, c’est-à-dire un modèle de langage utilisé comme juge. Chez ViaSay, éditeur français d’assistants conversationnels, c’est le rôle de l’AI Quality Monitoring. Il évalue 100 % des conversations terminées, et non un échantillon, y compris les parcours scriptés sans IA générative.
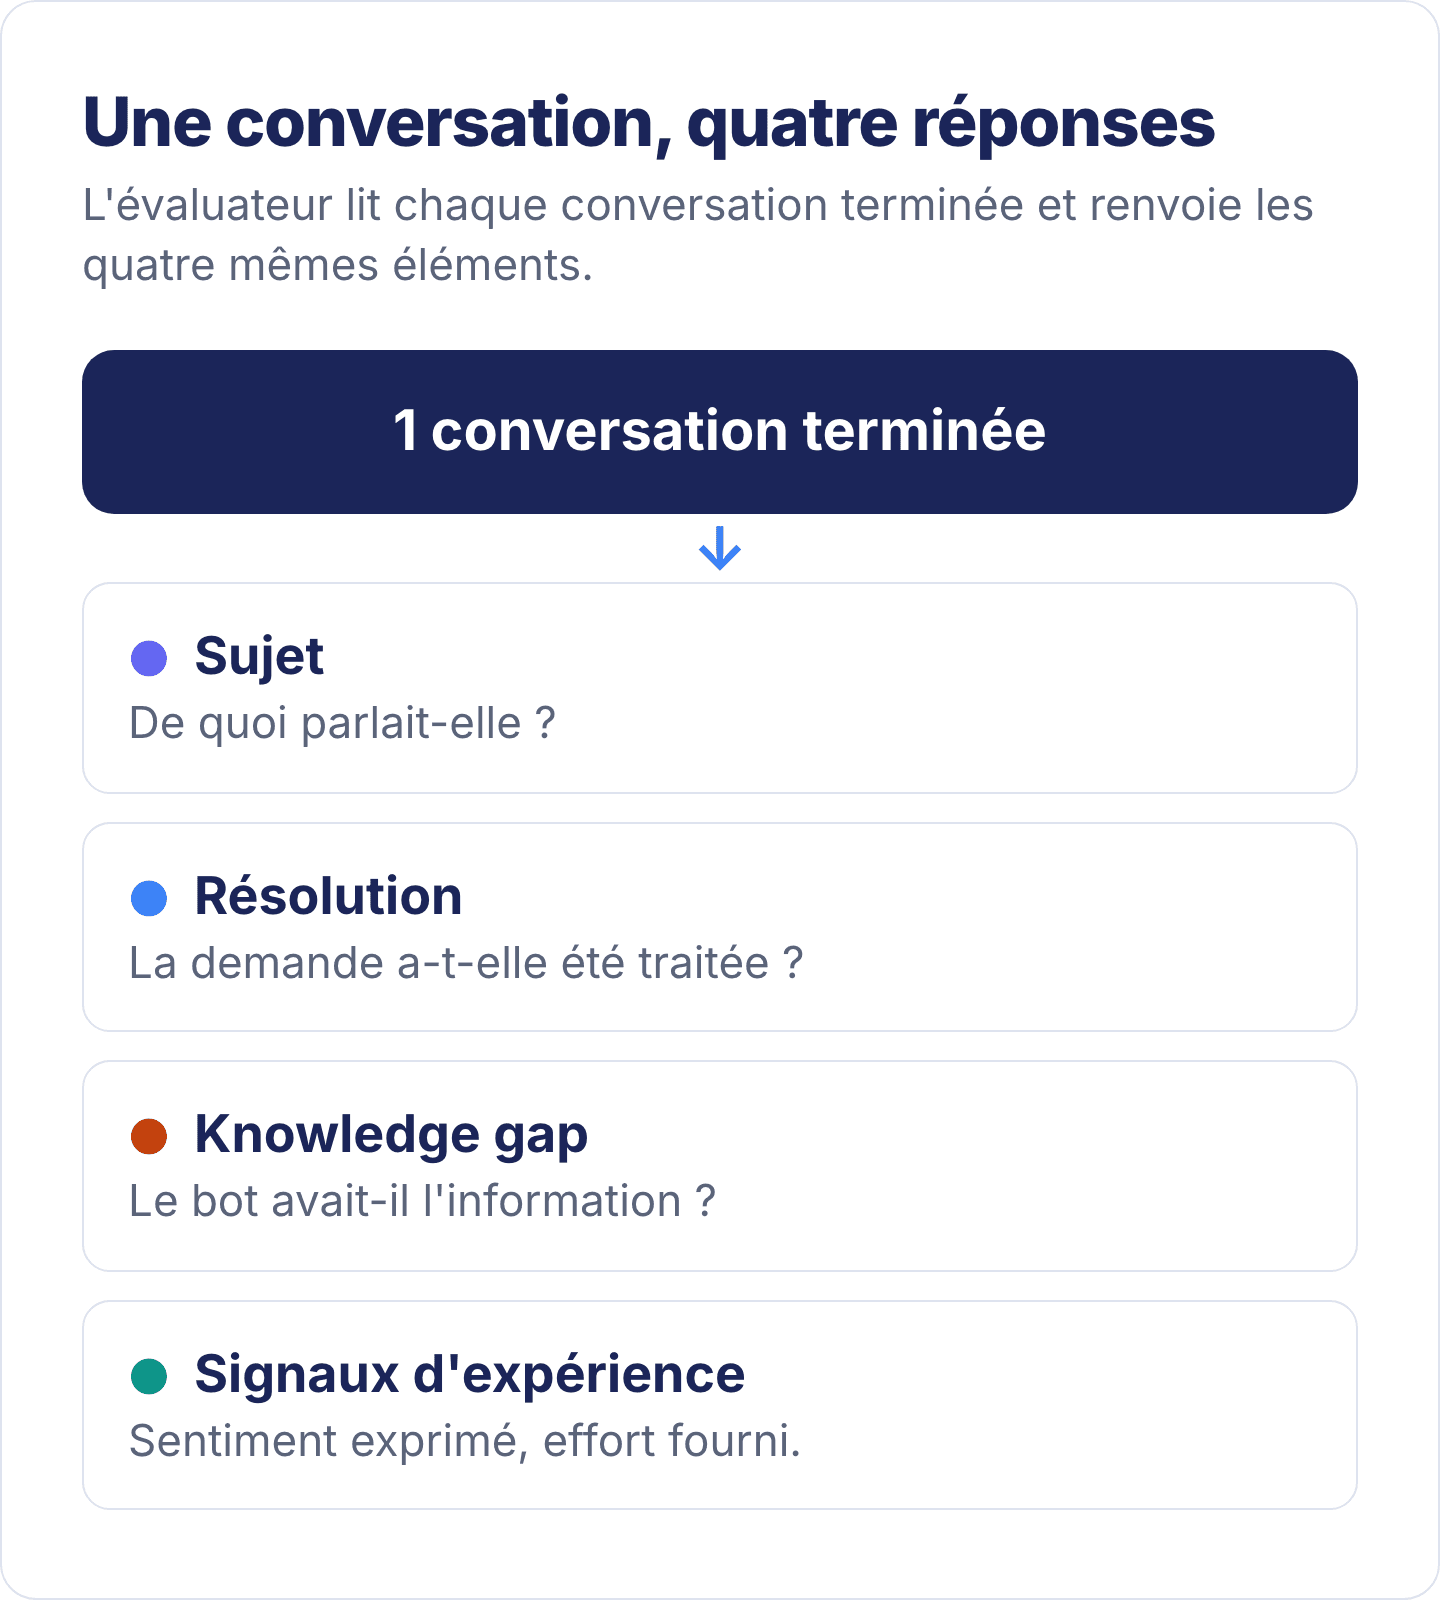
Pour chaque conversation, l’évaluateur répond à quatre questions :
De quoi parlait-elle ? Il choisit un sujet dans une liste fermée que vous contrôlez : paiement, modification de réservation, bagages, etc.
La demande a-t-elle été traitée ? Le verdict est « résolu » ou « non résolu » : c’est le taux de résolution.
Le bot avait-il l’information ? Sinon, c’est un knowledge gap, c’est-à-dire une information absente de la base de connaissances : le signal sur lequel on peut agir le plus directement.
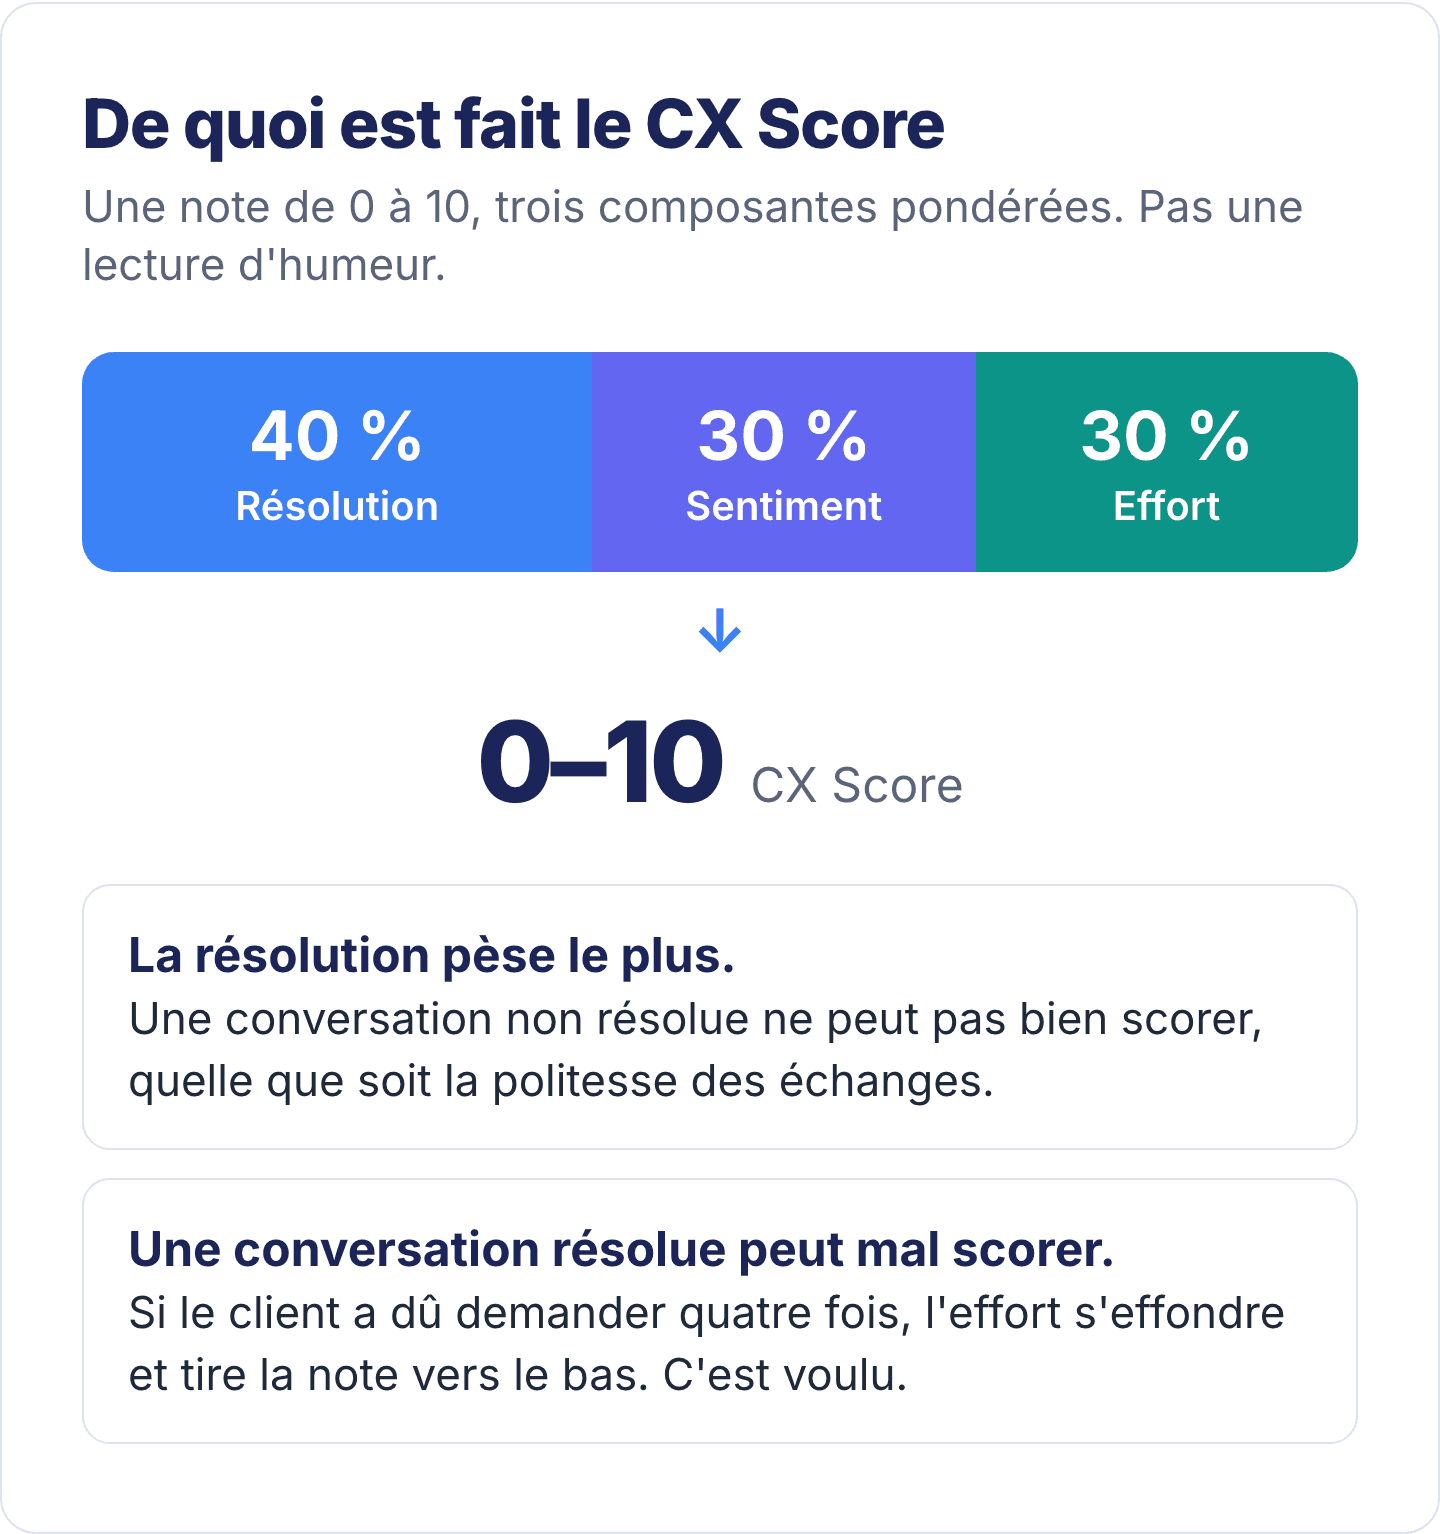
Comment l’utilisateur l’a-t-il vécue ? Le sentiment et l’effort sont combinés à la résolution dans un CX Score sur 10.
L’évaluateur met à part un troisième cas : le client n’a jamais formulé de demande, ou il est parti pendant une étape en attente. Il pouvait s’agir d’une question posée, d’un identifiant demandé, d’un choix à faire ou d’un transfert à accepter. Ces conversations ne disent rien sur la qualité du bot, ni dans un sens ni dans l’autre.
L’évaluation a lieu après la fin de la conversation, jamais pendant.
Les critères qui font qu’une conversation est résolue ou non
C’est sur ce point que la plupart des définitions s’effondrent. Voici les critères de l’évaluateur.
Ce qui est compté comme résolu :
Une réponse directe et pertinente à la demande.
Une redirection vers une ressource valide et alignée avec la demande, par exemple une page de suivi de commande quand le client veut suivre sa commande.
Une escalade correcte vers un humain qui traite la demande.
Un bot qui identifie que l’action nécessite le support, le dit clairement et donne un moyen concret de le joindre.
Un lien proposé que le client a suivi, ou un parcours entièrement en boutons qui aboutit à ce qu’il cherchait.
Ce qui est compté comme non résolu :
Une réponse générique ou hors sujet.
Une demande jamais comprise.
Un refus d’escalade sans alternative.
Une redirection alors que le bot pouvait répondre.
Une conversation qui se termine sans résolution ni escalade propre.
Une réponse qui se résume à « aucun conseiller n’est disponible en ce moment », même avec un rappel proposé. Le client repart sans rien à faire de son côté.
Le silence du client ne décide rien : l’évaluateur juge ce qui lui a été donné avant qu’il parte. Un client silencieux après une orientation utilisable a été servi ; après une réponse vide, il ne l’a pas été.
Un client qui part alors qu’on lui demandait son numéro de réservation n’est pas jugé du tout. C’est la différence avec une « résolution assumée », où le silence vaut accord par défaut.
Une escalade bien gérée est une résolution. Un bot qui reconnaît ses limites et passe la main proprement a fait son travail.
Le sentiment du client n’entre pas dans le verdict de résolution. Une politique d’annulation correctement énoncée à un client furieux est une conversation résolue. Le mécontentement est mesuré ailleurs, dans le CX Score, et ce choix est délibéré : mélanger les deux rendrait les deux illisibles.
Dans le tableau de bord, chaque chiffre se vérifie conversation par conversation
Le taux de résolution ne prend pas la forme d’un rapport mensuel : c’est un indicateur vivant, affiché dans le même écran que le volume et le taux de transfert. Chaque métrique jugée par l’IA y est signalée, et chaque chiffre renvoie aux conversations qui le composent.
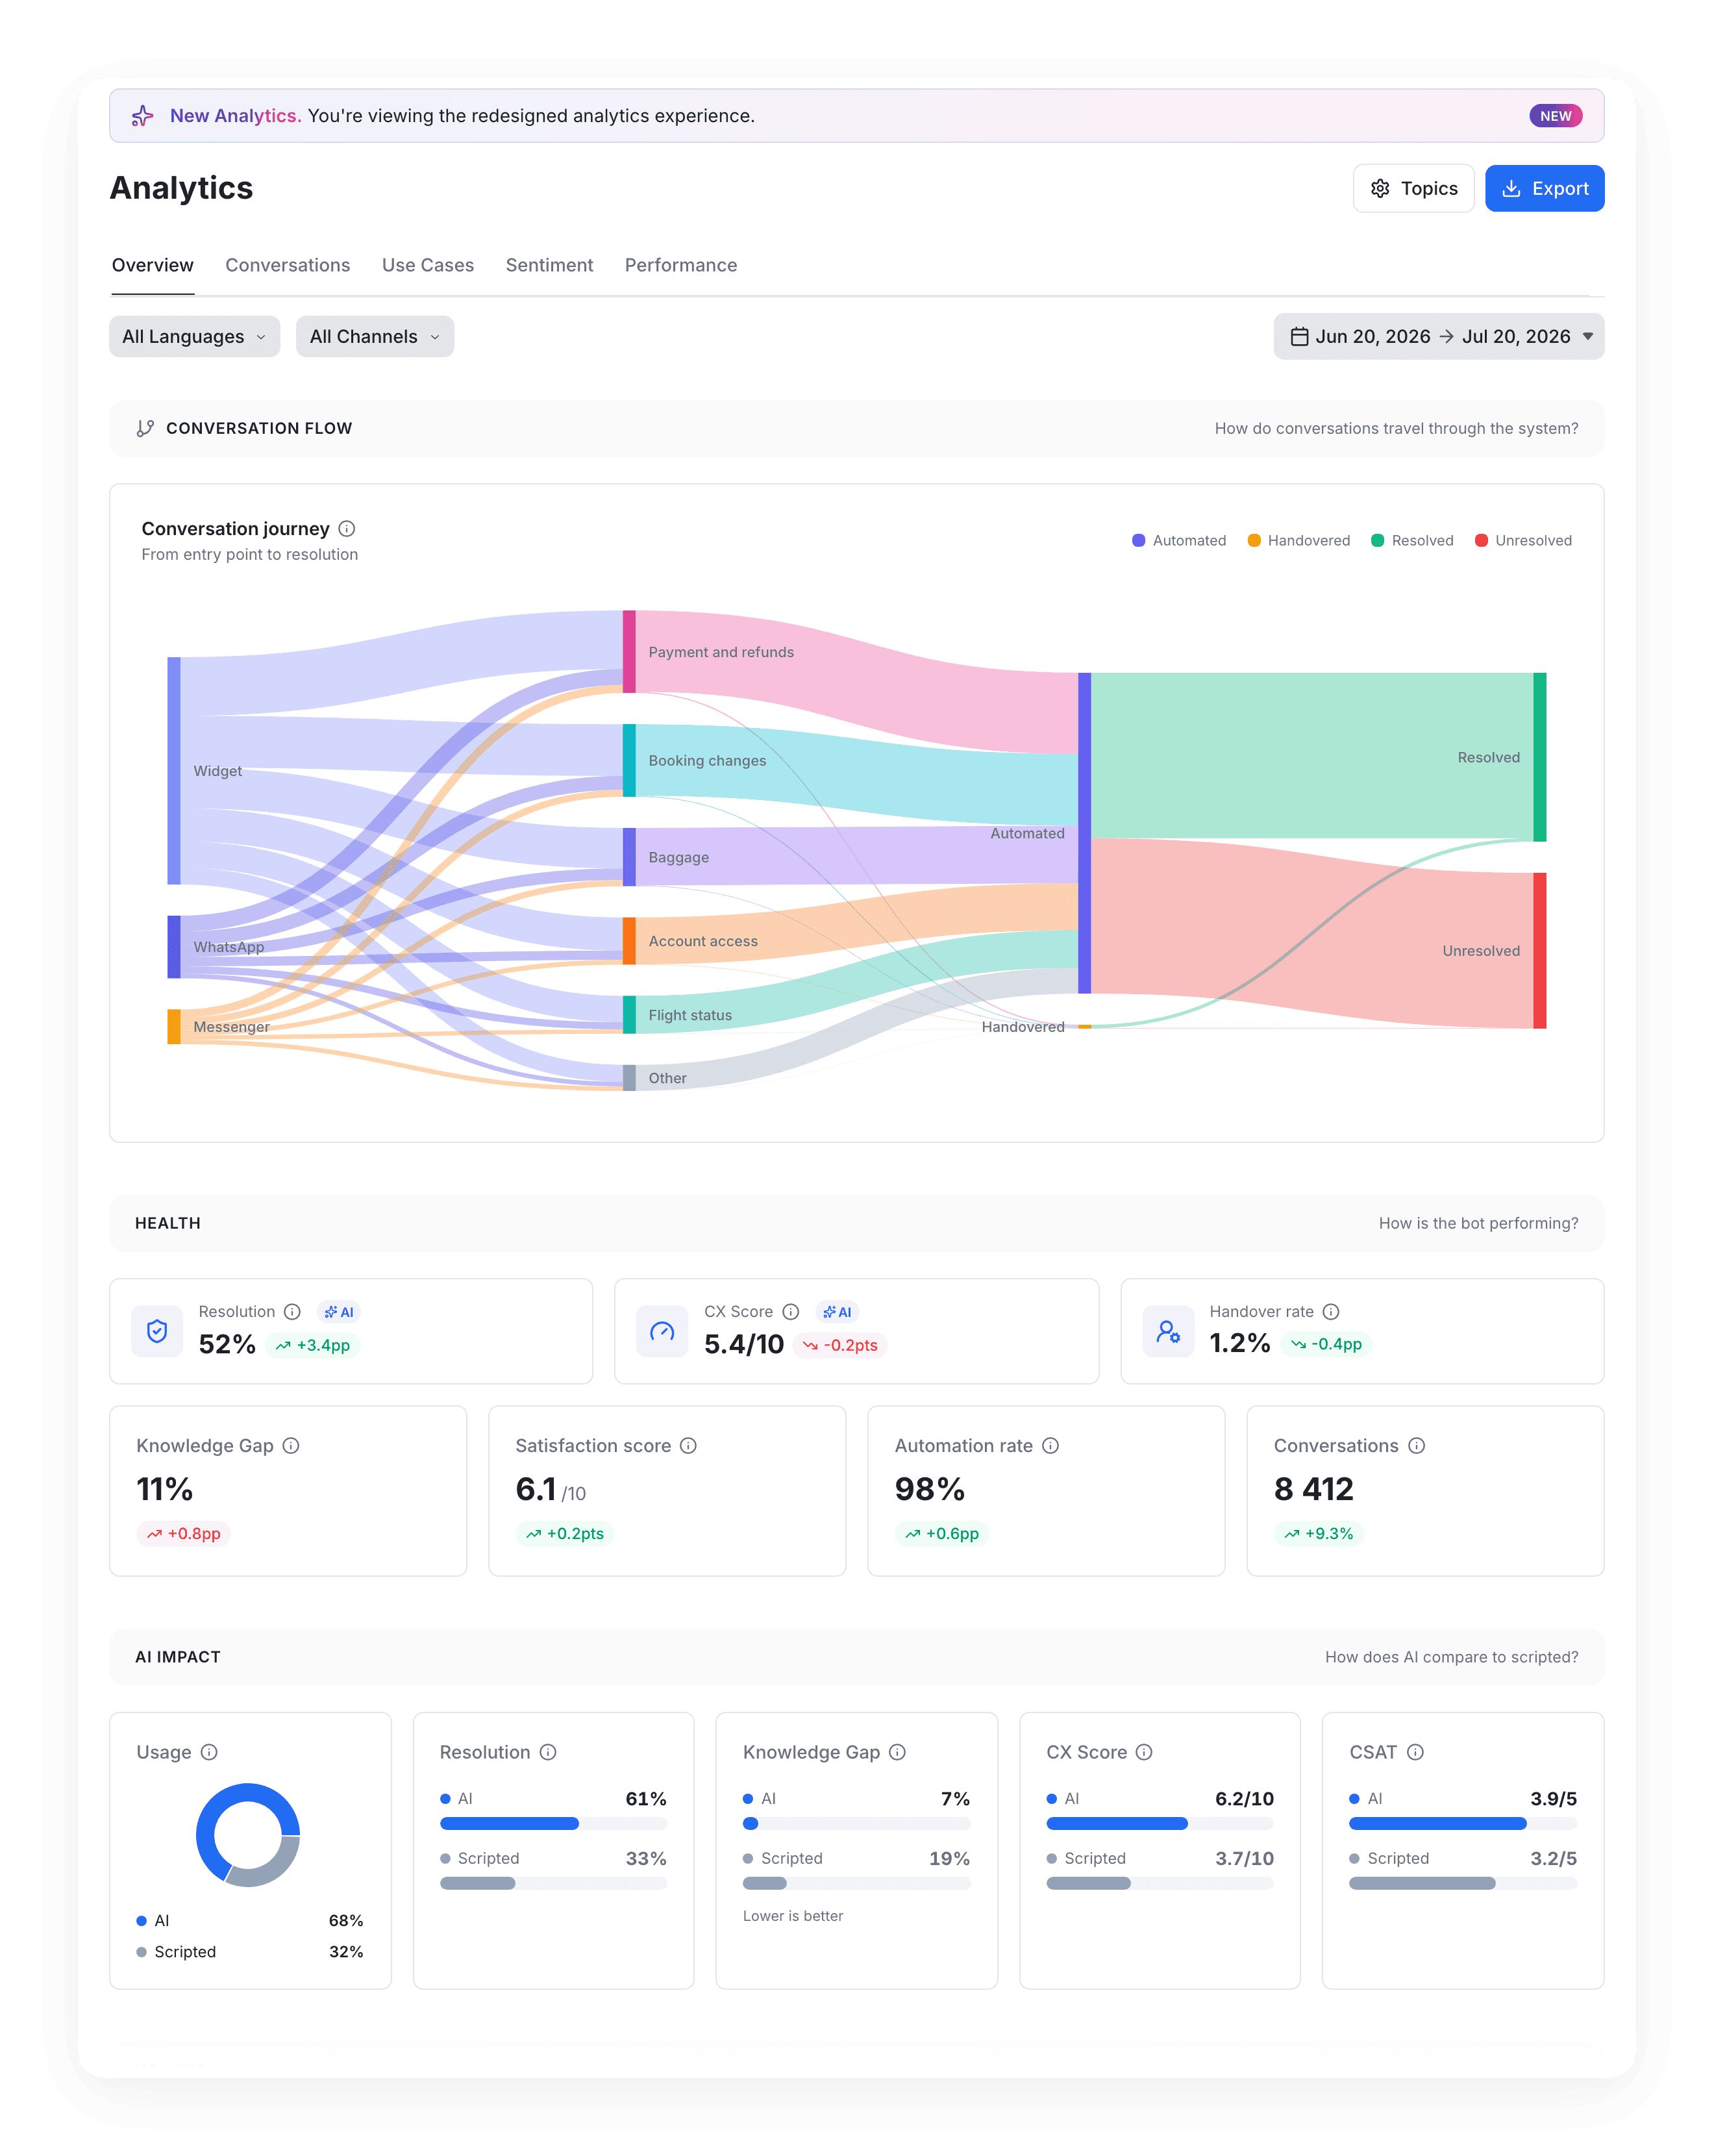
Cette capture, réalisée avec des données de démonstration, montre trois éléments.
Le taux de résolution est à 52 %, à côté d’un taux d’automatisation à 98 %. Ce sont les deux chiffres présentés plus haut, côte à côte. Le second n’a pas bougé quand on a commencé à mesurer le premier, et c’est le premier que vous pouvez améliorer.
Chaque métrique issue de l’IA porte un badge « AI ». Vous distinguez toujours ce qui est compté, comme le volume, les transferts ou les votes CSAT (les notes de satisfaction données par les clients), de ce qui est jugé.
La section AI Impact compare les conversations gérées par l’IA générative et celles gérées par des parcours scriptés, sur les mêmes critères. Elle répond à la question : « l’IA fait-elle mieux, chez nous, sur nos sujets ? »
Derrière chaque chiffre, il y a les conversations. Un clic sur n’importe quel indicateur ouvre leur liste, déjà filtrée, avec le verdict et le score de chacune.
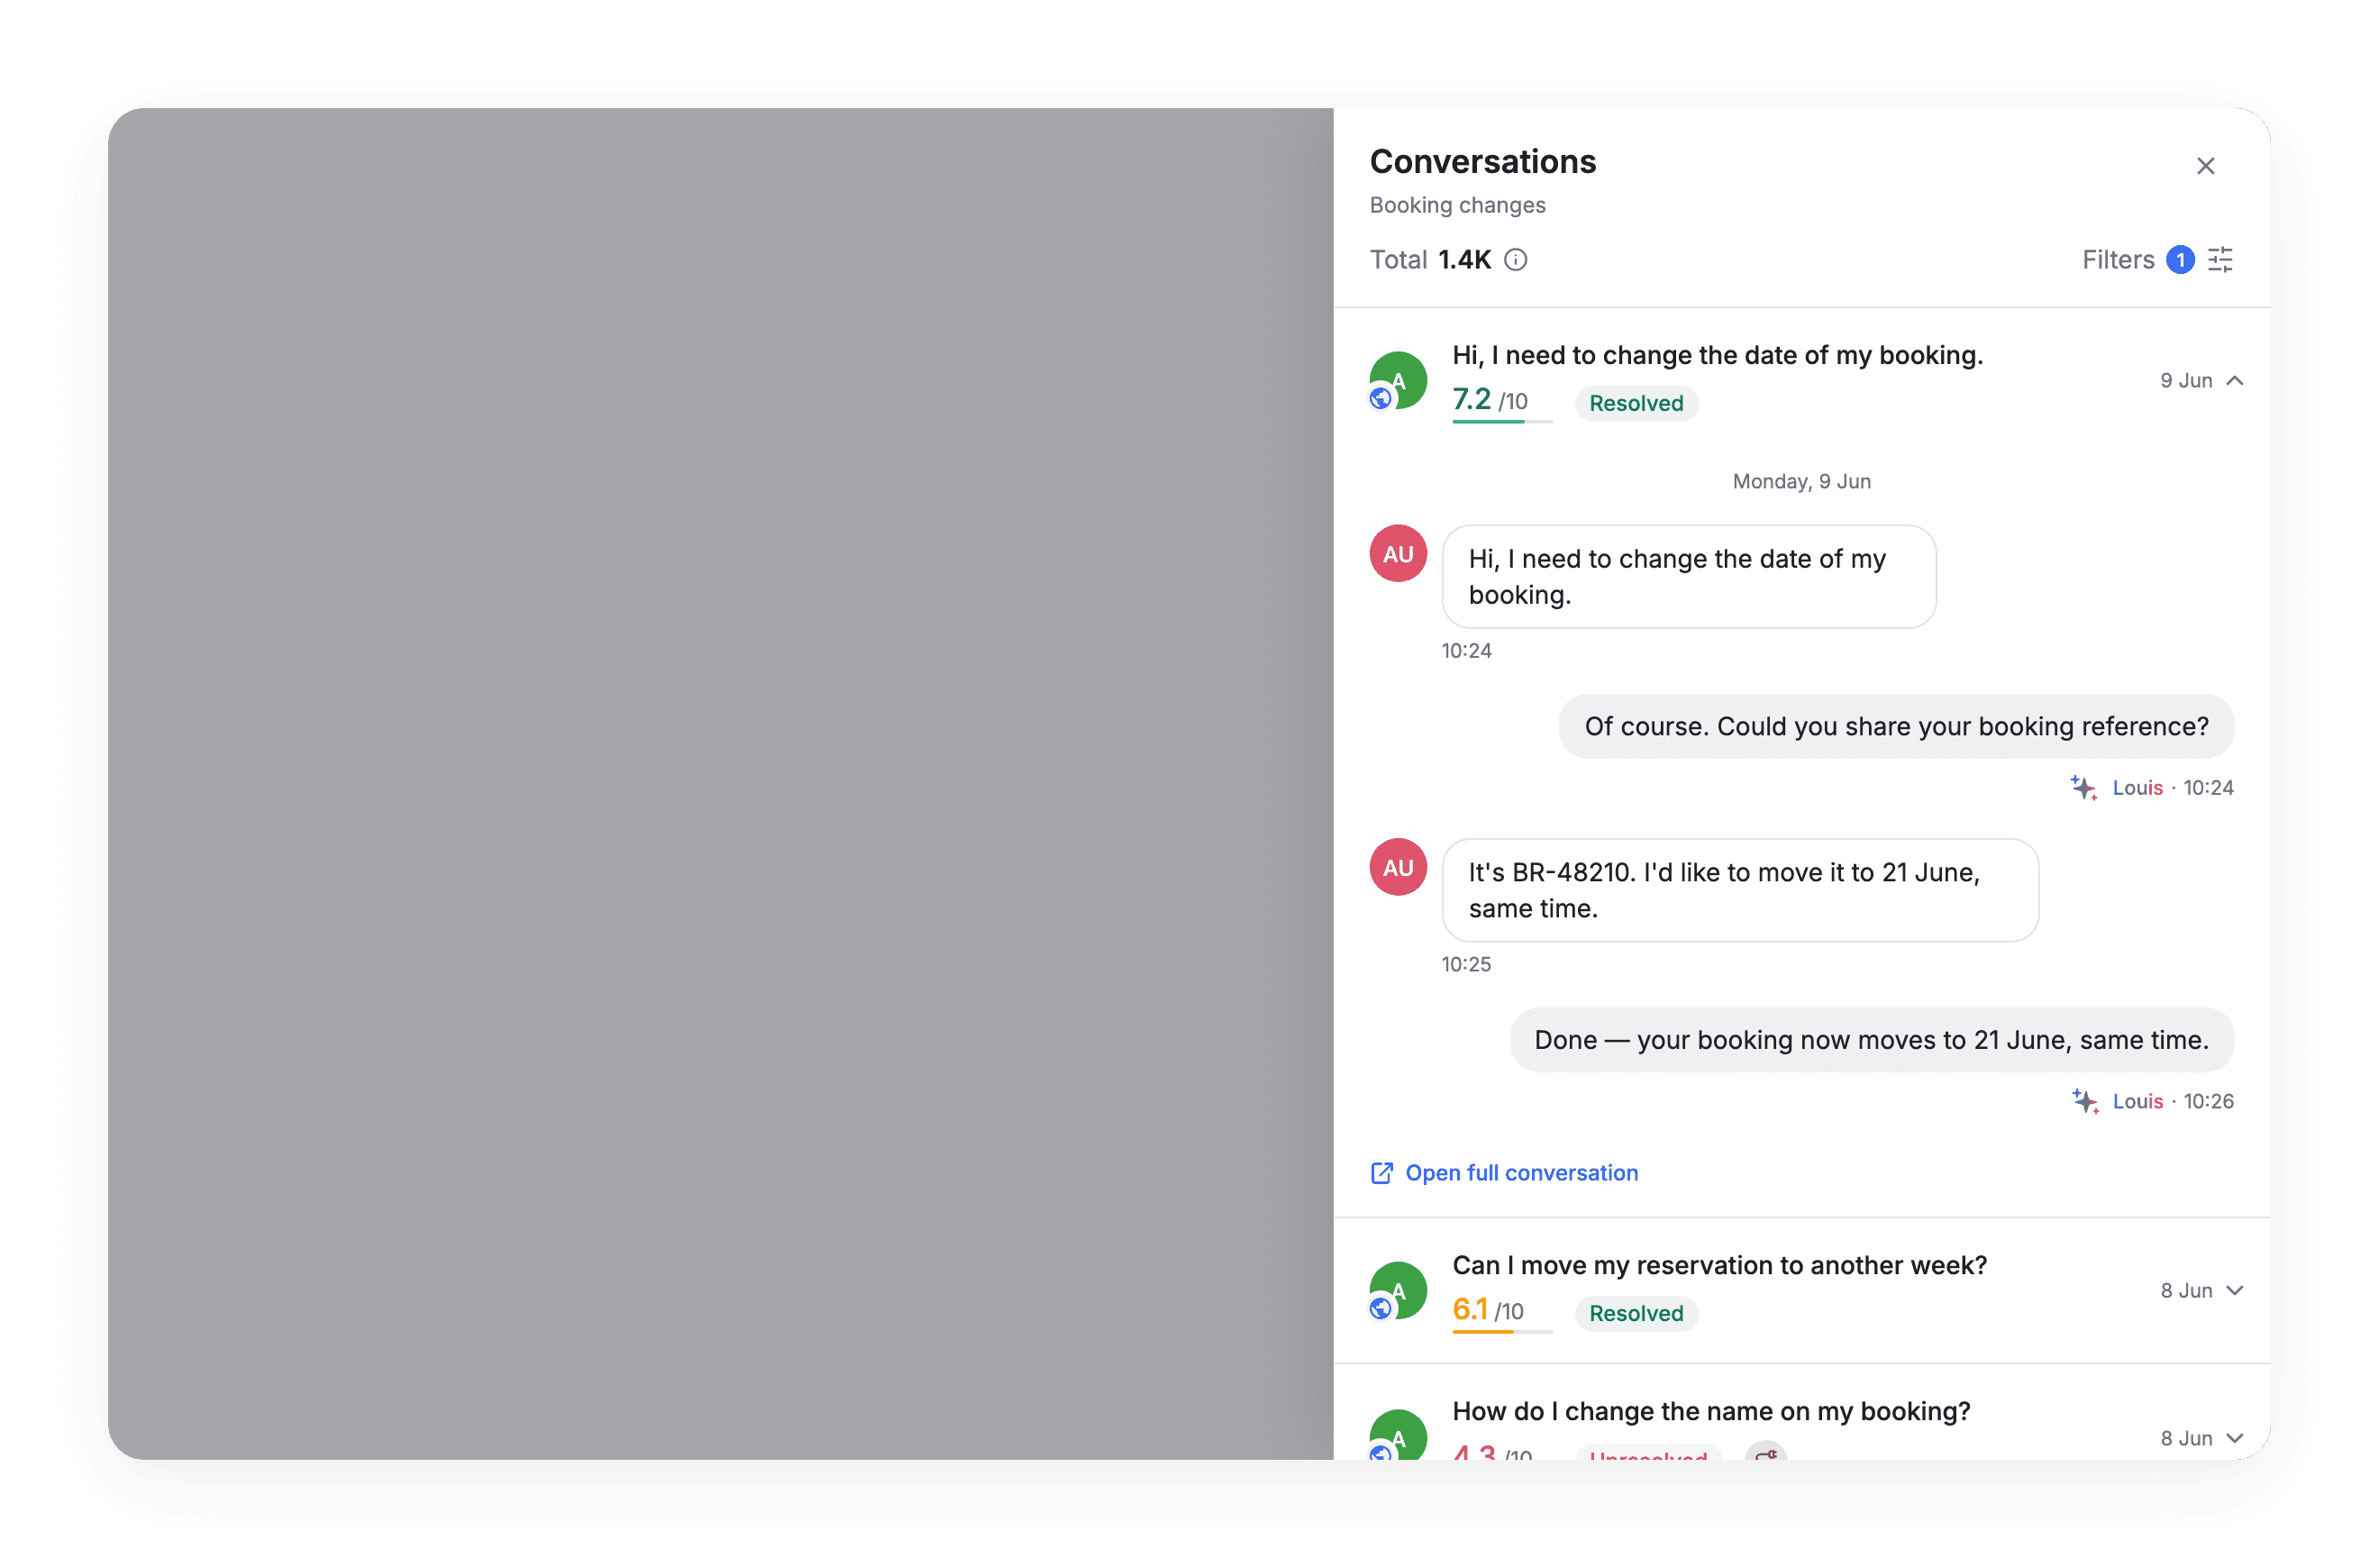
Chaque verdict est accompagné de sa justification
Sur chaque conversation, survolez le tag Resolved, Unresolved ou Knowledge gap : l’évaluateur donne sa justification en une phrase.
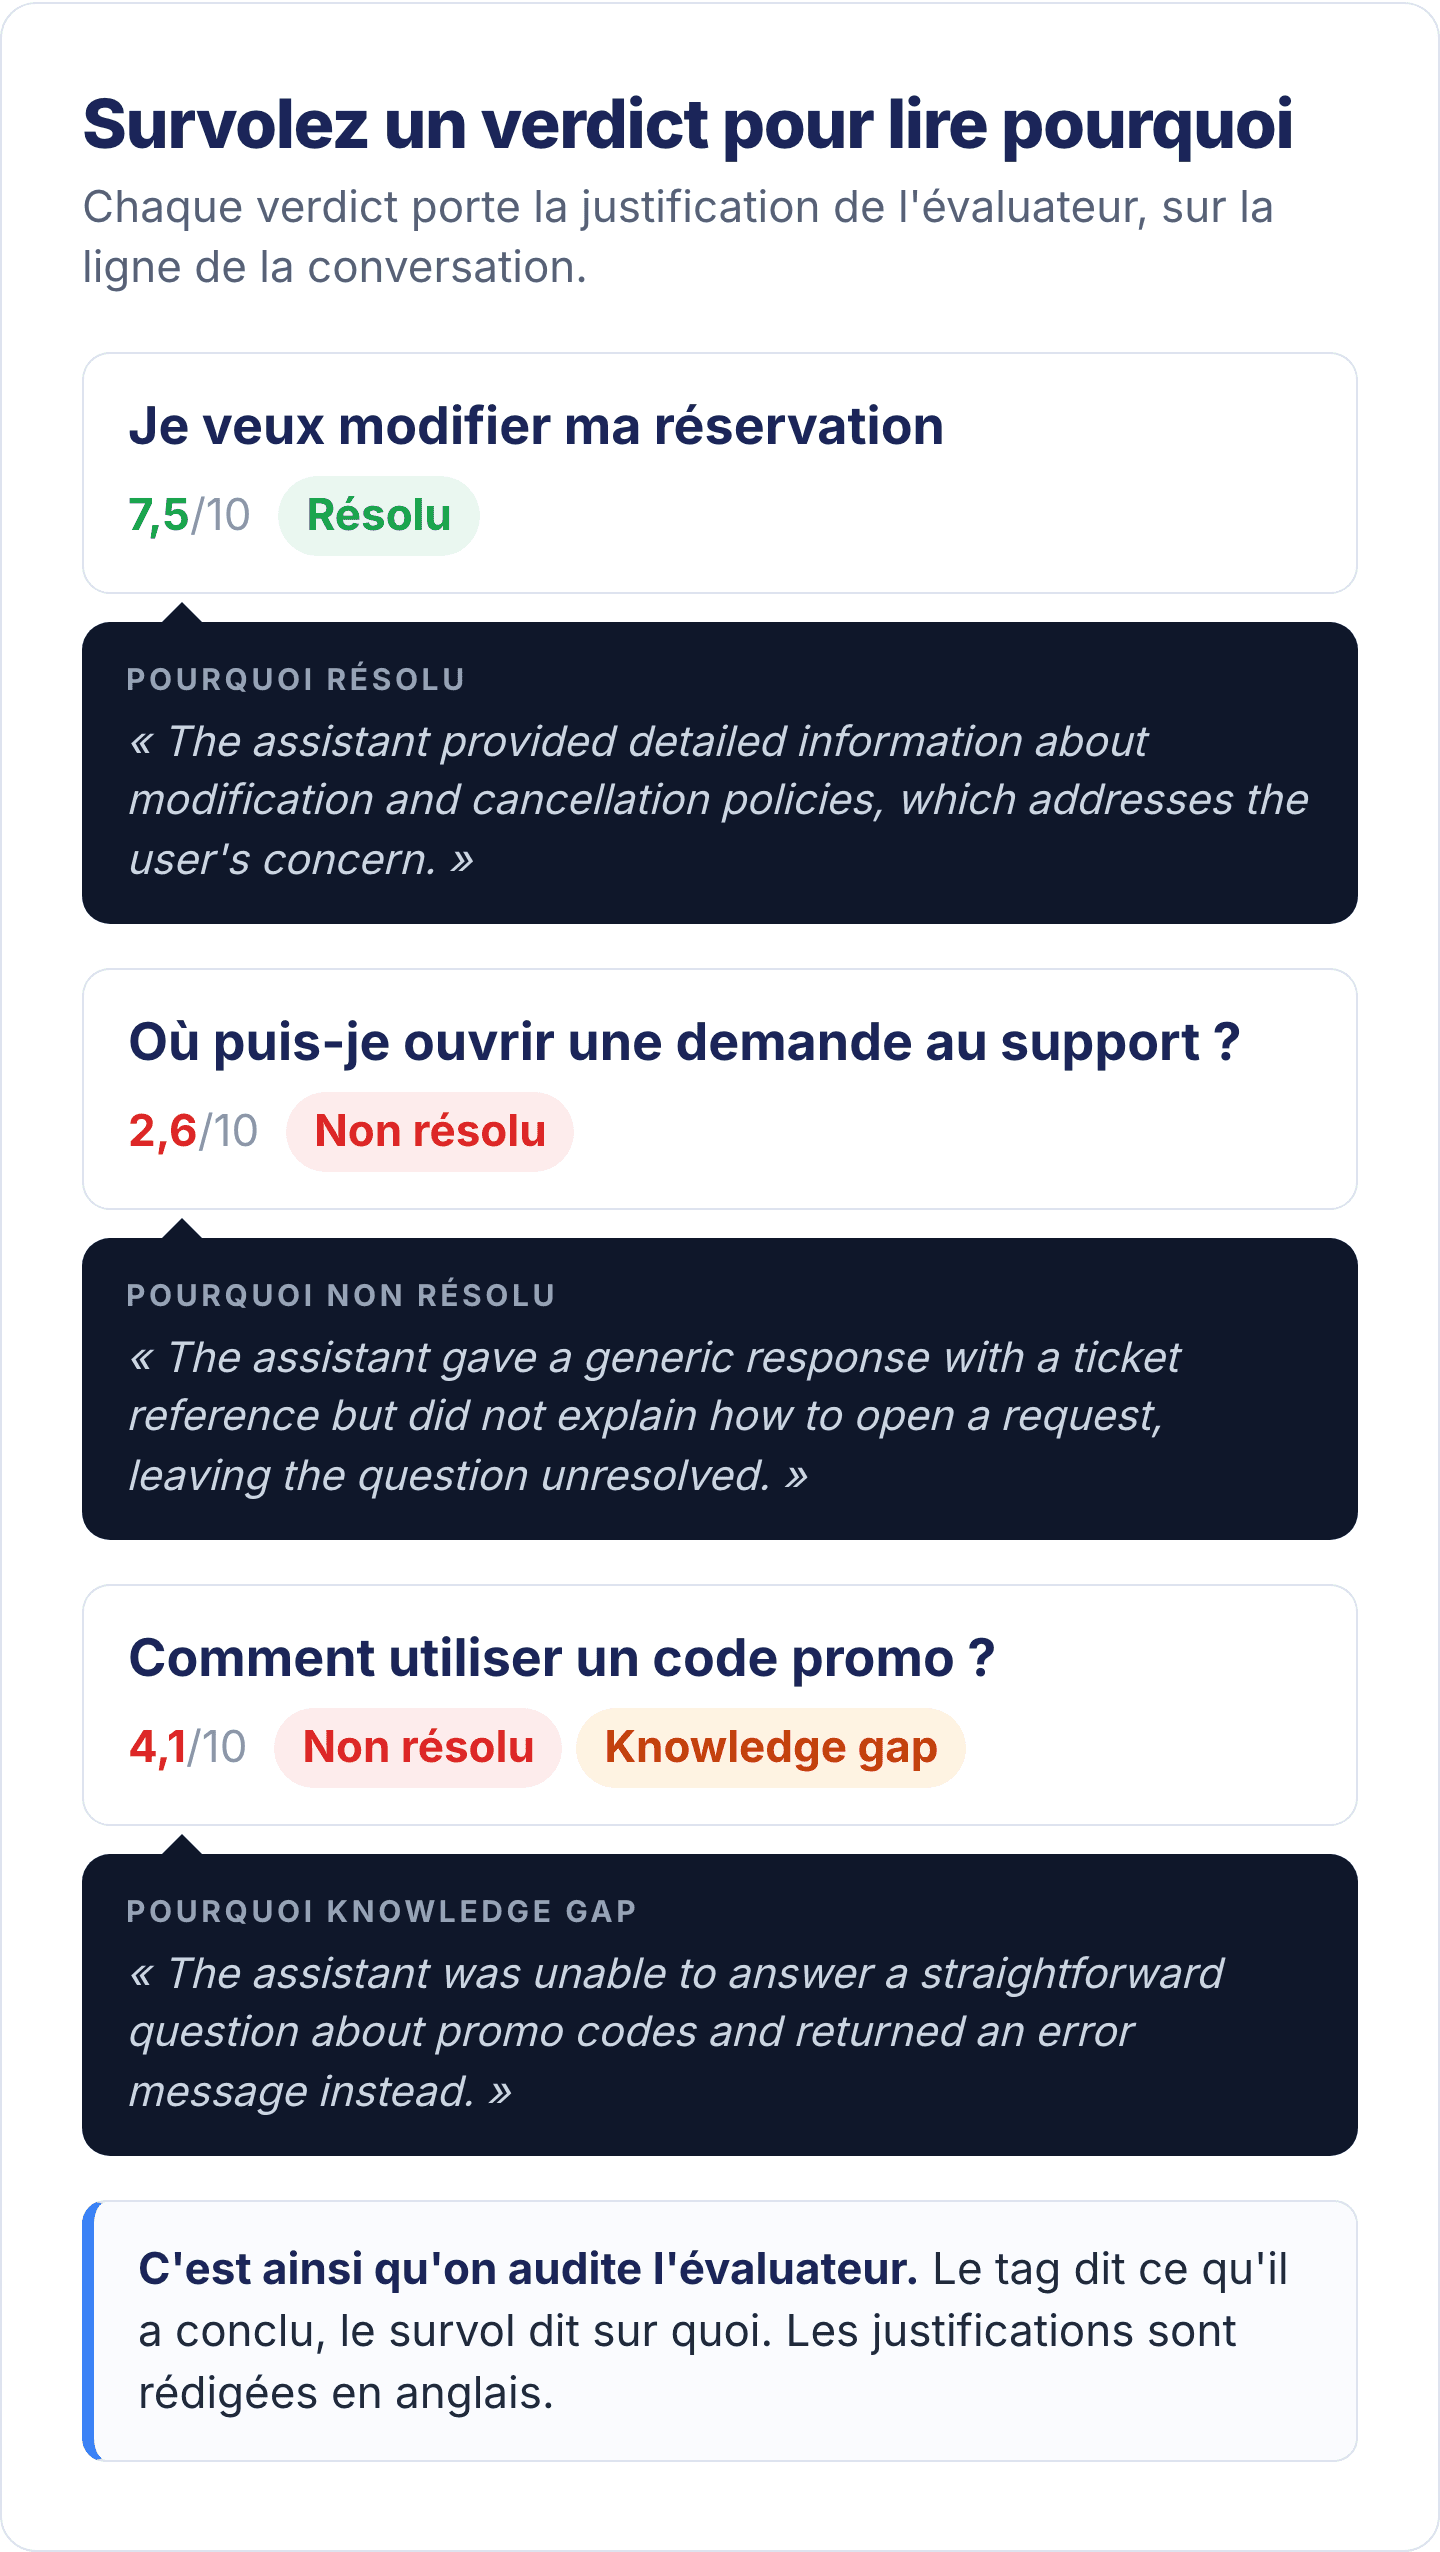
Vous n’avez donc pas à croire un pourcentage sur parole. Vous pouvez ouvrir n’importe quelle ligne, lire la justification puis la conversation, et vous faire votre propre avis. Un chiffre que l’on peut auditer est un chiffre que l’on peut présenter.
Le premier taux de résolution vérifié est souvent plus bas que prévu
Quand vous passez d’un taux d’automatisation à un taux de résolution vérifié, le chiffre baisse, souvent beaucoup. Prenons un bot en production depuis des années, avec un bon taux d’automatisation et des clients satisfaits. Le premier mois de mesure, il découvre souvent un taux de résolution réel autour de 40 %.
Ce bot n’était pas mauvais pour autant : la mesure a rendu visible ce qui ne l’était pas. Avant la mesure, on suppose que tout va bien ; le jour où l’on mesure, tout semble cassé. Aucune des deux impressions n’est juste.
Aujourd’hui, les clients ViaSay en production se situent entre 50 et 85 % de résolution, mesurée conversation par conversation par l’évaluateur. L’écart entre le bas et le haut de la fourchette ne tient pas à la technologie, qui est la même pour tous.
Il tient à ce que chaque équipe fait de la mesure : voir quel sujet échoue, comprendre pourquoi, puis corriger une chose à la fois. Un sujet « problèmes techniques » peut passer de 32 % à 64 % de résolution en quelques semaines, quand son knowledge gap tombe de 33 % à 11 %. Une fois que l’on voit ce qui manque, on peut l’écrire.
Mesurez d’abord, améliorez ensuite. Un taux de résolution bas n’est pas une mauvaise note : il vous montre où agir. La façon de s’en servir fait l’objet d’un second article, la méthode en 5 étapes pour améliorer le taux de résolution de votre chatbot IA.
Voir votre vrai taux de résolution, sur vos conversations
Une démo de 30 minutes de l’AI Quality Monitoring, sur vos sujets et vos parcours, et non sur les nôtres.
Deux indicateurs complètent le taux de résolution : le knowledge gap et le CX Score
Le taux de résolution dit qu’une conversation a échoué, mais ni pourquoi, ni comment le client l’a vécue. Le knowledge gap répond à la première question, en indiquant si le bot avait l’information. Le CX Score répond à la seconde, avec une note sur 10 calculée pour toutes les conversations.
Le knowledge gap. Une politique de remboursement absente de la base de connaissances est un knowledge gap. En revanche, une redirection correcte vers l’espace client pour une donnée personnelle n’en est pas un : le bot n’a pas à connaître votre solde.
Cette distinction rend le signal exploitable : un sujet avec 25 % de knowledge gap, c’est une liste d’articles à écrire.
Le CX Score combine, dans une note sur 10, la résolution (40 %), le sentiment exprimé (30 %) et l’effort fourni par l’utilisateur (30 %). Ce n’est pas un CSAT prédit : le CSAT reste le vote réel des clients, et il ne concerne que la petite minorité qui vote. Le CX Score couvre tout le monde.
Quelles sont les limites d’un évaluateur IA ?
Un évaluateur IA n’est pas un oracle, et connaître ses limites rend le reste crédible. Il peut se tromper, ne lit que la conversation, ignore vos règles métier et ne retient qu’un sujet par conversation. Utilisez-le comme une boussole, et non comme un verdict contractuel.
Il peut se tromper, dans les deux sens. Sur une conversation limite, un humain pourrait juger autrement. C’est pour cela que chaque verdict est justifié et que chaque conversation reste lisible.
Il ne lit que la conversation. Il ne sait pas que votre site était en panne ce matin-là, ni que le client avait déjà appelé deux fois.
Il ne connaît pas vos règles métier : si le bot énonce avec assurance une information fausse mais plausible, l’évaluateur peut compter la conversation comme résolue. Il mesure si la demande a été traitée, pas si la réponse était vraie. La fidélité à la source est un autre sujet, traité en amont par les garde-fous de l’agent.
Il retient un seul sujet par conversation. Une conversation qui aborde trois sujets est classée sous un seul.
L’évaluateur vous indique où regarder parmi les milliers de conversations que vous ne lirez jamais. C’est précisément ce qui manquait.
Comment obtenir un taux de résolution que vous pouvez défendre ?
Un taux de résolution se défend quand vous savez ce qu’il compte, qui le vérifie et quelles conversations se trouvent derrière. Si vous ne pouvez pas ouvrir la conversation derrière le pourcentage, ce n’est pas un taux de résolution. Trois étapes permettent de passer d’un compteur d’automatisation à une mesure vérifiée.
Vérifiez ce que compte votre tableau de bord. Une conversation sans transfert n’est pas une demande traitée.
Faites lire chaque conversation terminée par une IA distincte du bot, avec des critères fixes, et vérifiez ses verdicts par échantillon.
Traitez votre premier chiffre comme un point de départ : repérez le sujet qui échoue, comprenez pourquoi, puis corrigez une chose à la fois.
Vous comparez des chatbots IA en ce moment ?
Demandez à chaque éditeur comment il compte une résolution, et qui la vérifie. Puis venez voir comment ViaSay le fait, sur vos propres conversations.
Questions fréquentes
Quel est un bon taux de résolution pour un chatbot IA ? Mesuré en lisant chaque conversation, un taux de résolution entre 40 et 55 % est un point de départ normal pour un bot en production. Les bots suivis et corrigés régulièrement atteignent 70 à 85 %, surtout lorsqu’ils sont connectés aux systèmes métier et capables d’agir. Un chiffre à 90 % ou plus mesure presque toujours l’automatisation, pas la résolution.
Quelle est la différence entre taux de déflexion et taux de résolution ? La déflexion compte les conversations qui n’ont pas atteint un agent humain, y compris celles où le client a abandonné. La résolution compte celles où la demande a été traitée. L’écart entre les deux dépasse souvent 30 points.
Comment mesurer le taux de résolution d’un chatbot sans lire toutes les conversations ? En faisant lire les conversations par une IA distincte du bot, avec des critères fixes, puis en vérifiant ses verdicts par échantillon. C’est le principe du « LLM as a judge ». L’important est que chaque verdict soit justifié et que la conversation reste accessible.
Une escalade vers un agent humain compte-t-elle comme un échec ? Non, si elle est correctement gérée. Un bot qui identifie que la demande dépasse son périmètre et transfère proprement a traité la demande. Un bot qui refuse l’escalade sans alternative, ou qui transfère une question à laquelle il pouvait répondre, a échoué.
Le CX Score remplace-t-il le CSAT ? Non. Le CSAT est le vote réel des clients, donné par une minorité. Le CX Score est calculé sur 100 % des conversations à partir de la résolution, du sentiment et de l’effort. Les deux se lisent ensemble.
