

🚀
GUIDE GRATUIT
RFP Chatbot : Ne partez pas d'une page blanche
Un mode d'emploi pensé pour les métiers avec un guide pas à pas pour rédiger chaque section de votre appel d'offres.
Méthodologie guidée : Quoi écrire dans chaque chapitre (Contexte, Fonctionnel, Tech)
Concepts clés décryptés : RAG, LLM, Base de connaissance
Modèles inclus : Structures prêtes à l'emploi pour vos cas d'usage
👉 Télécharger le guide
Vous avez maintenant un vrai taux de résolution. Pas le taux d'automatisation à 95 %, le vrai : celui obtenu en faisant lire chaque conversation par une IA, comme expliqué dans notre article sur la mesure du taux de résolution. Il est autour de 50 %. Et la question suivante arrive tout de suite : on fait quoi ?
La mauvaise réponse est « on refait le bot ». La bonne tient en une boucle d'une heure, répétable chaque mois, qui produit à chaque fois quelques points de résolution en plus. Les clients ViaSay en production se situent entre 50 et 85 % de résolution mesurée ; ce qui sépare le bas du haut de la fourchette, c'est cette boucle, pas une refonte.
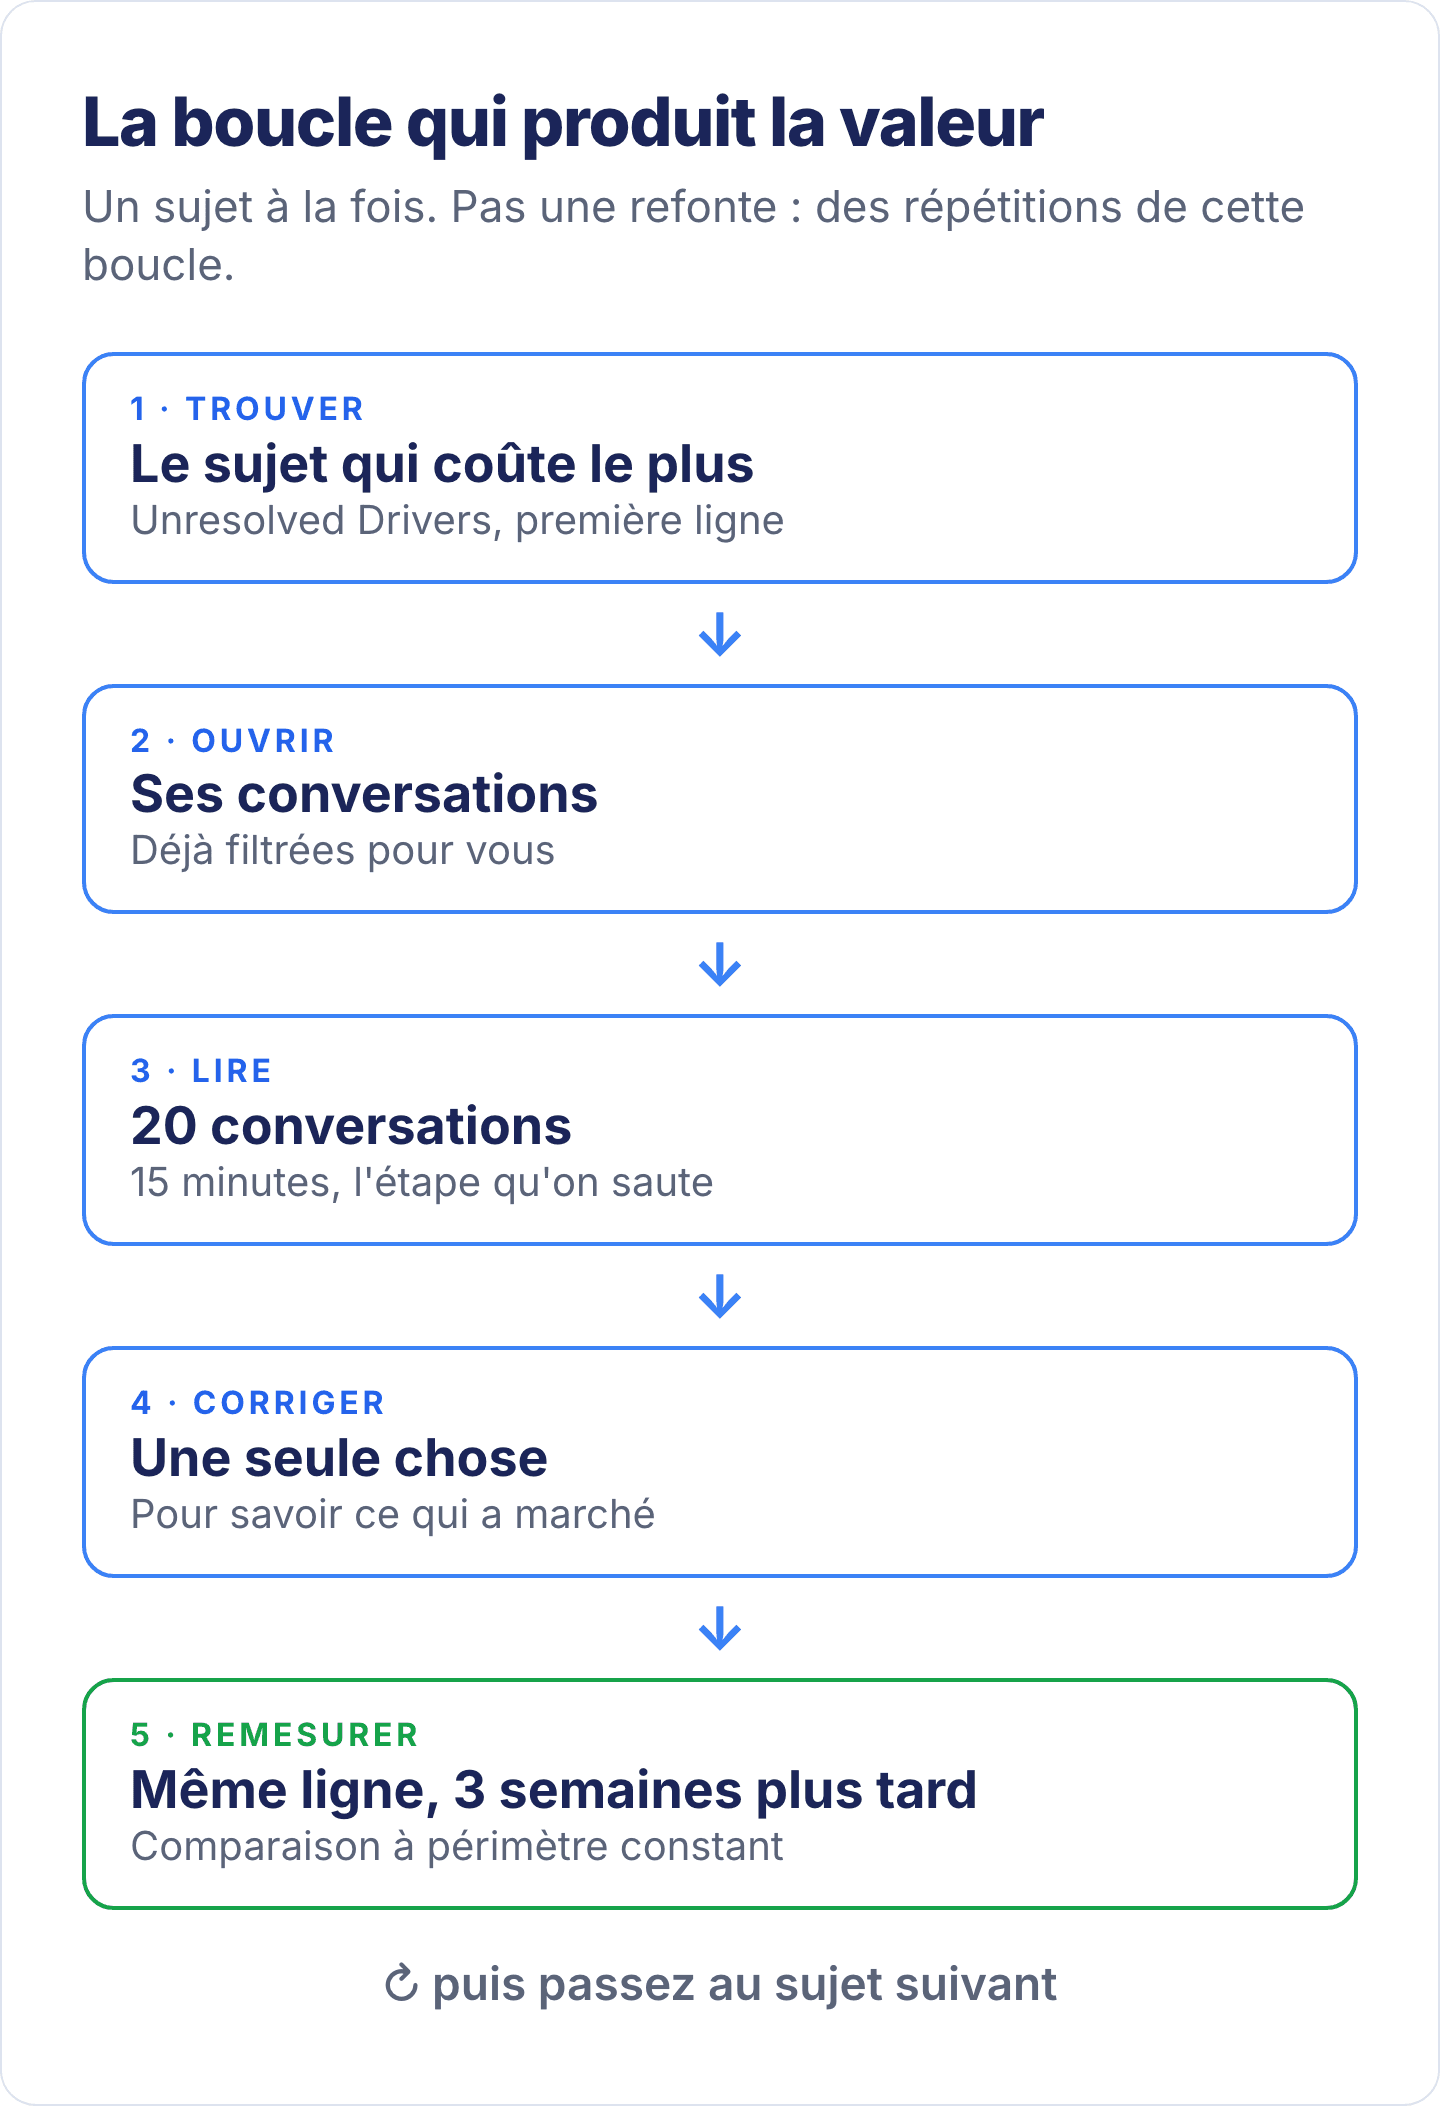
Voici les cinq étapes, avec l'écran correspondant à chacune.
Étape 1 : classez vos sujets par conversations perdues, pas par pourcentage
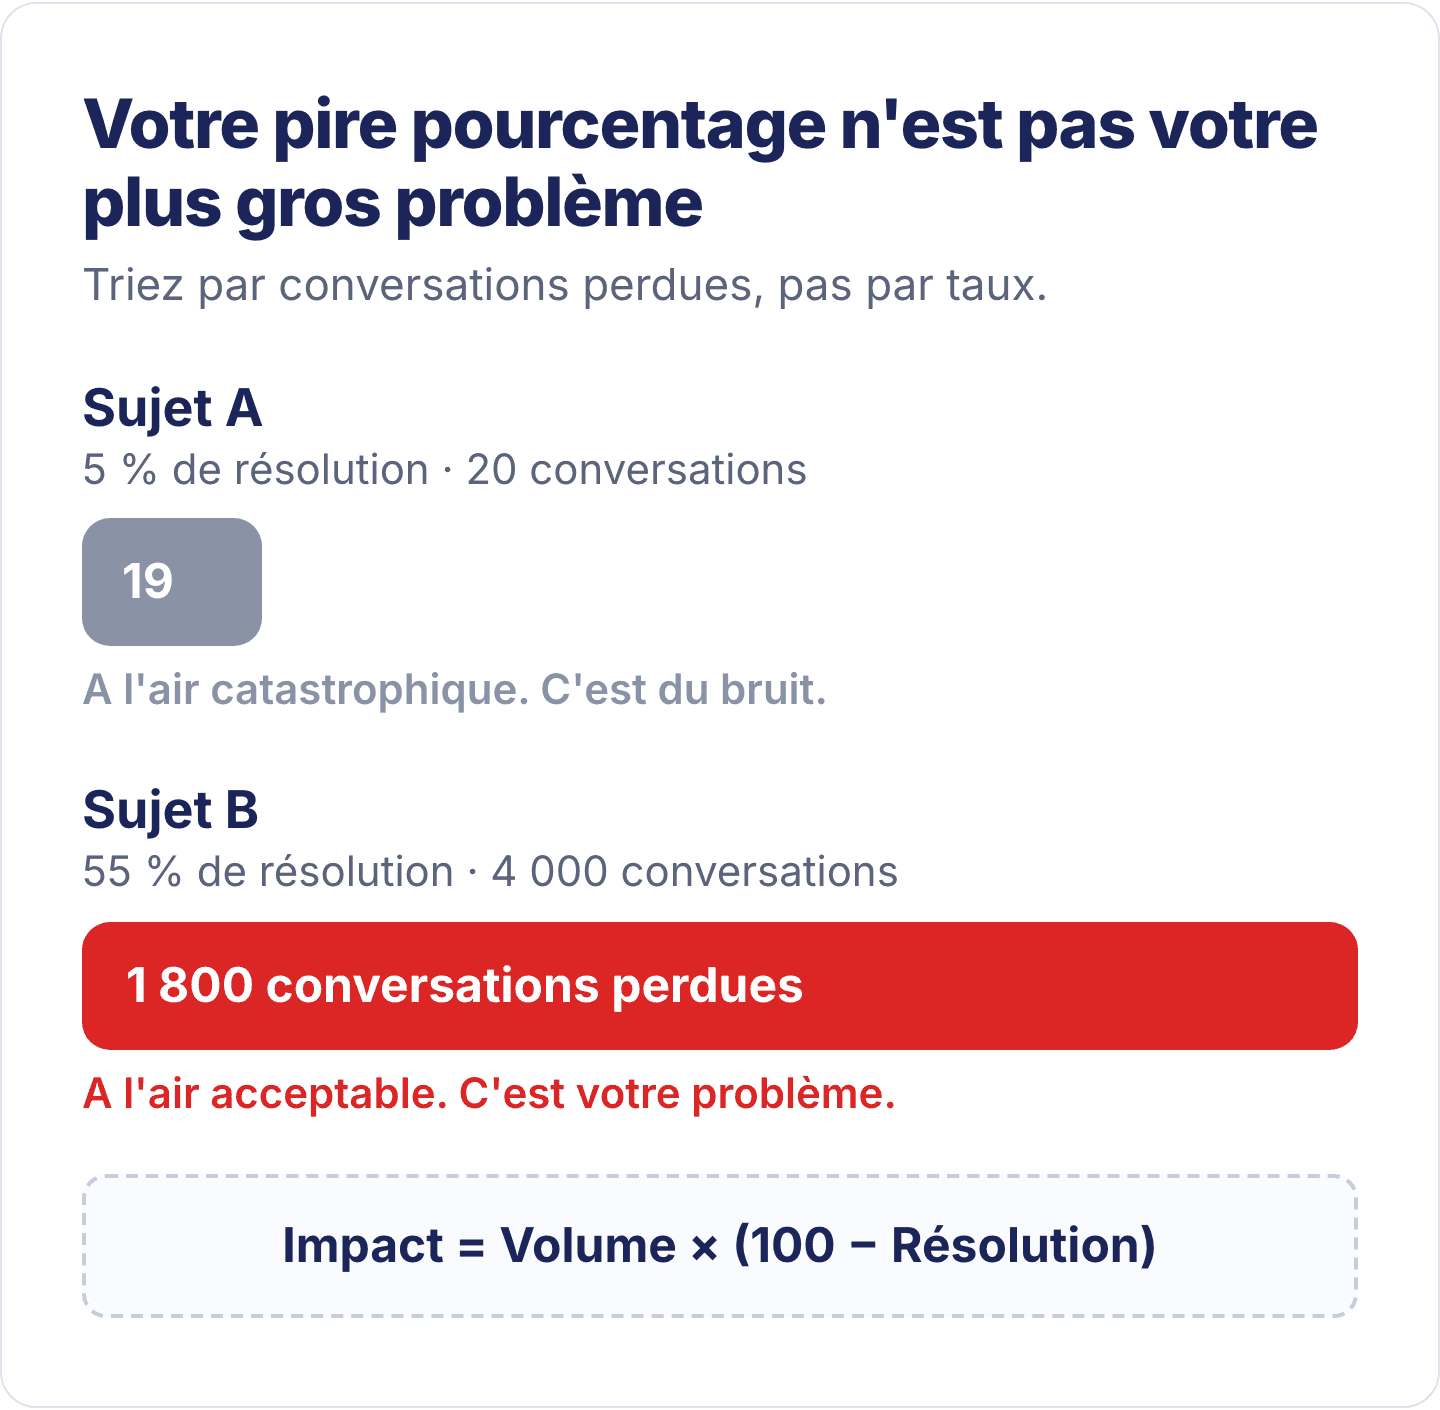
Le réflexe naturel est de trier les sujets par taux de résolution croissant et d'attaquer le pire. C'est le meilleur moyen de perdre une semaine sur un sujet qui ne compte pas.
Ce qui coûte, ce n'est pas un pourcentage. C'est un nombre de conversations non résolues. Il faut donc trier par :
Impact = Volume × (100 − Résolution)
Deux exemples pour sentir la différence :
Un sujet à 5 % de résolution sur 20 conversations a l'air catastrophique. Il vaut 19 échecs. C'est du bruit.
Un sujet à 55 % de résolution sur 4 000 conversations a l'air acceptable. Il vaut 1 800 échecs. C'est votre problème.
Dans ViaSay, ce tri est déjà fait. Le tableau Unresolved Drivers, dans l'onglet Performance, classe vos sujets par impact et affiche pour chacun le volume, le taux de résolution et le taux de knowledge gap.
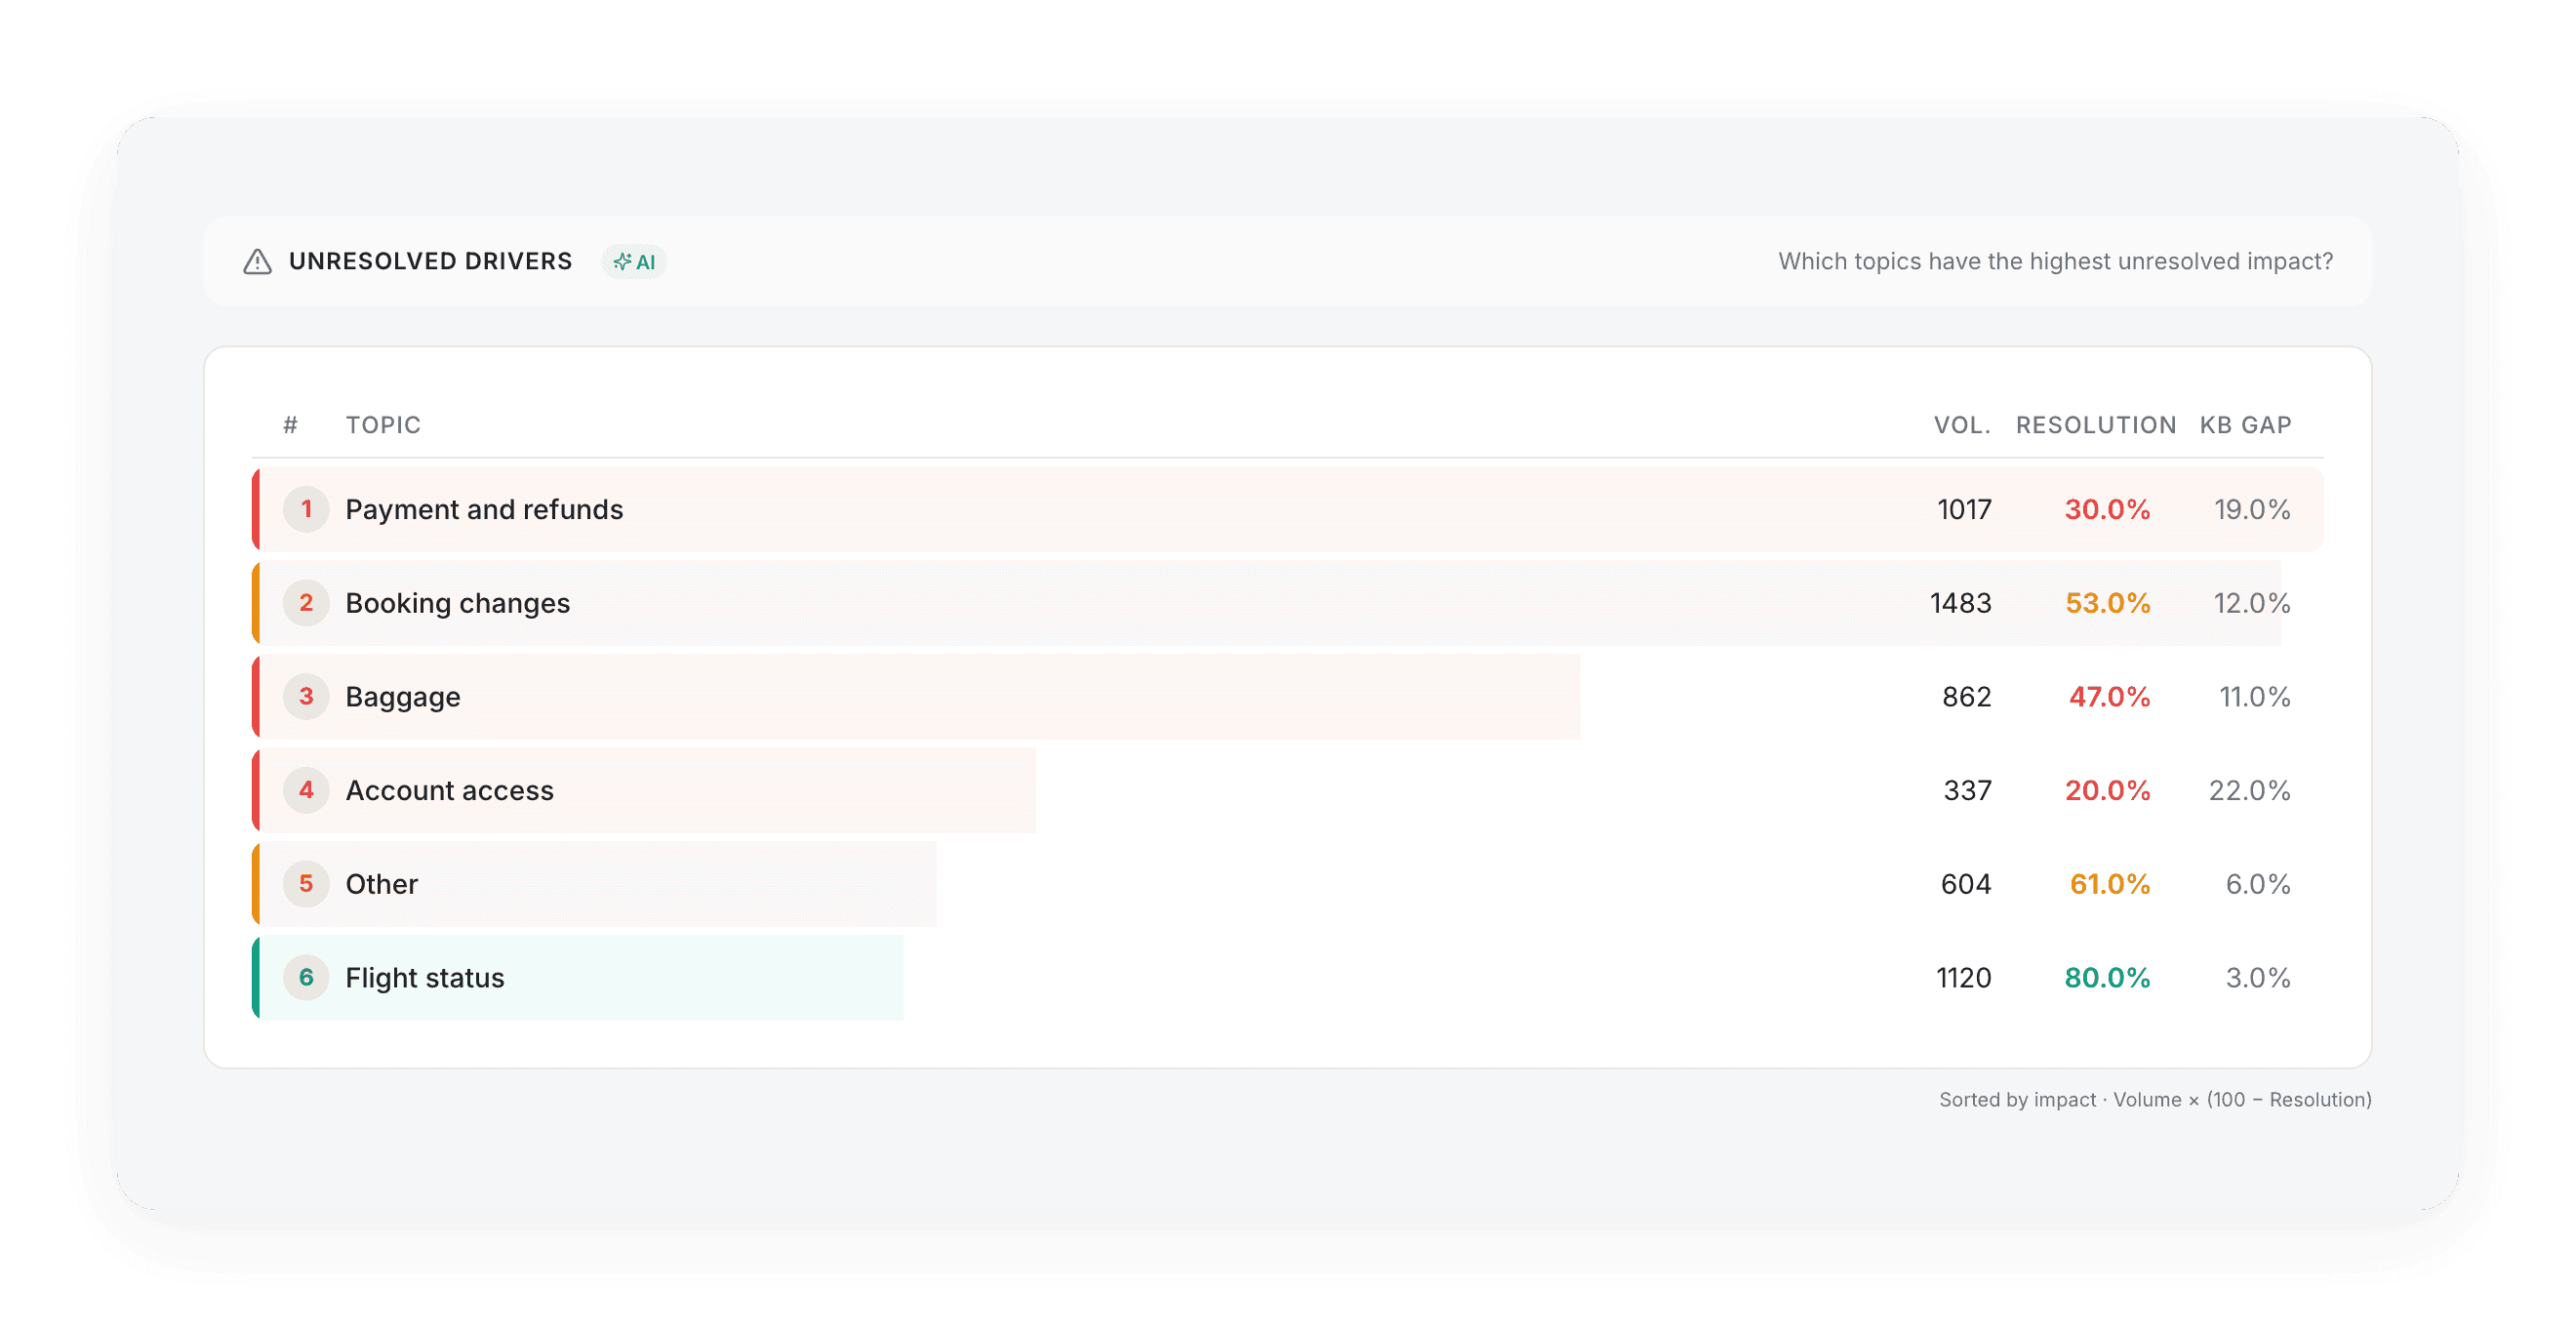
Sur cette capture (données de démonstration), « Booking changes » est à 53 % de résolution, mieux que « Account access » à 20 %. Il est pourtant classé plus haut : 1 483 conversations contre 337. C'est lui qu'il faut ouvrir en premier.
Commencez en haut du tableau. Toujours.
Étape 2 : ouvrez les conversations derrière le chiffre
Un chiffre ne se corrige pas. Une conversation, si.
Cliquez sur le sujet. Un panneau s'ouvre avec les conversations de ce sujet, déjà filtrées sur les non résolues. Chaque ligne porte le verdict de l'évaluateur, son CX Score, et la première question de l'utilisateur.
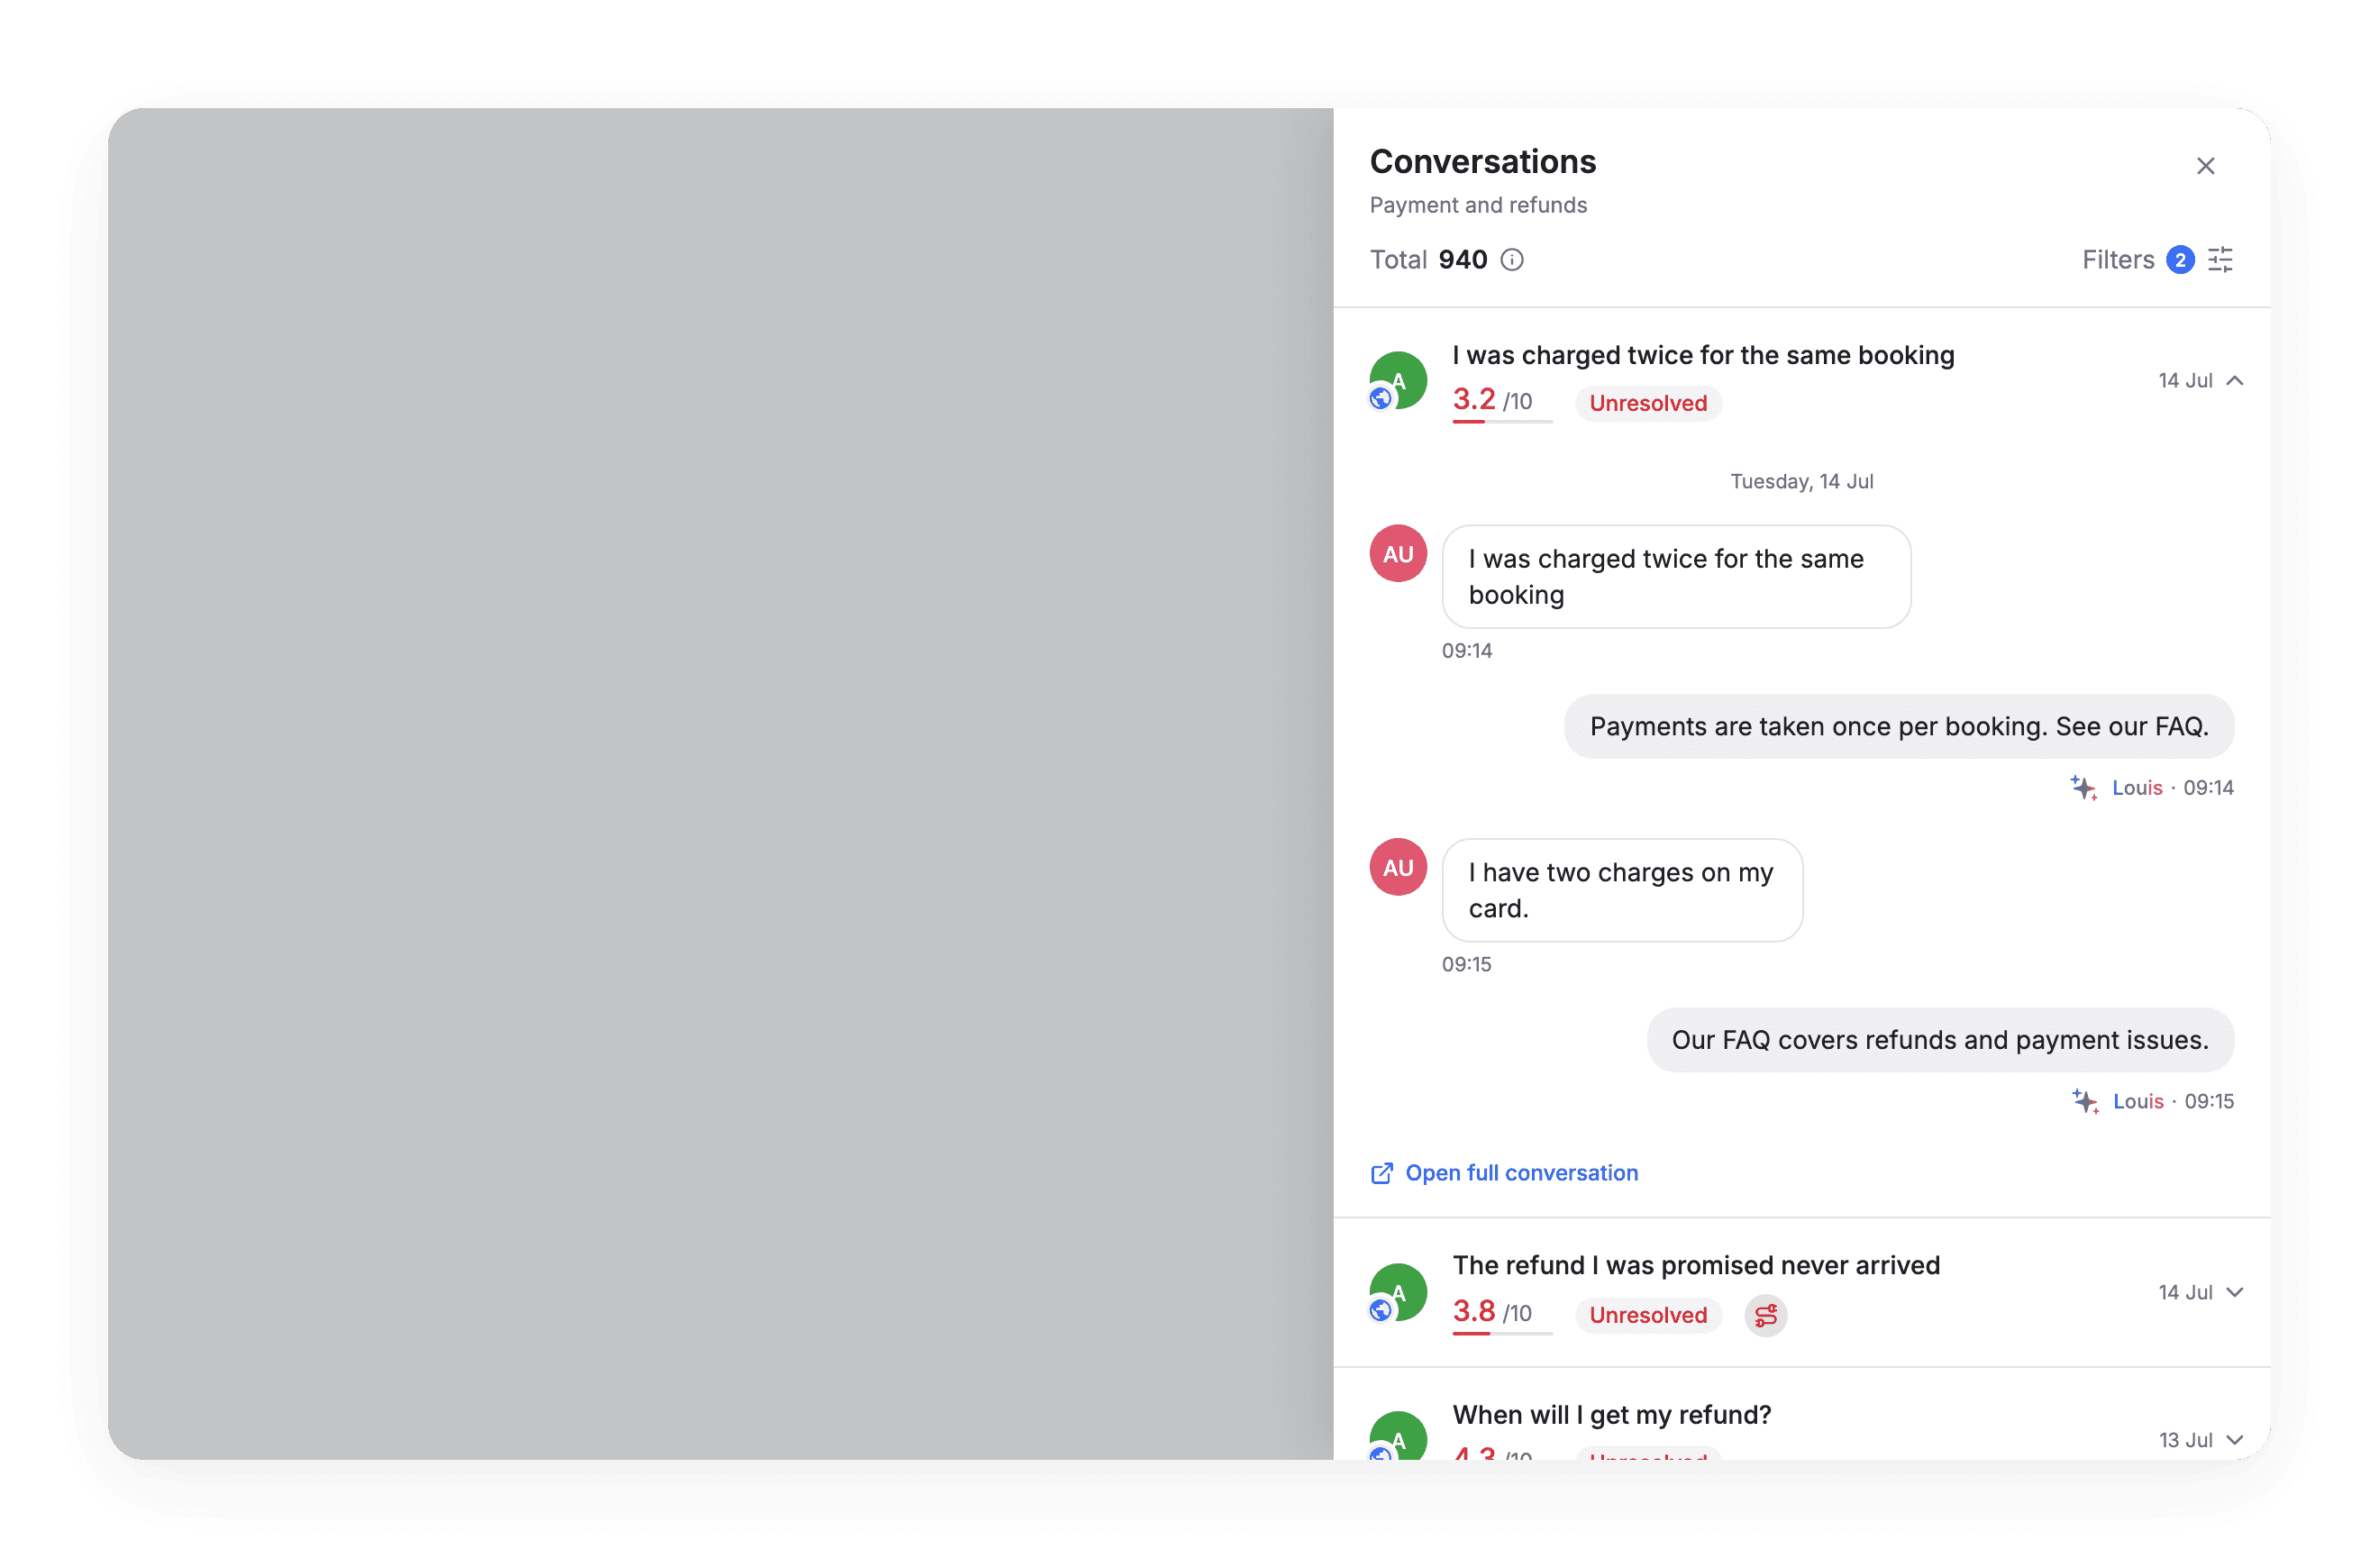
Avant d'ouvrir une seule conversation, survolez les tags. L'évaluateur explique en une phrase pourquoi il a jugé la conversation non résolue. C'est le moyen le plus rapide de trier une liste de 200 lignes.
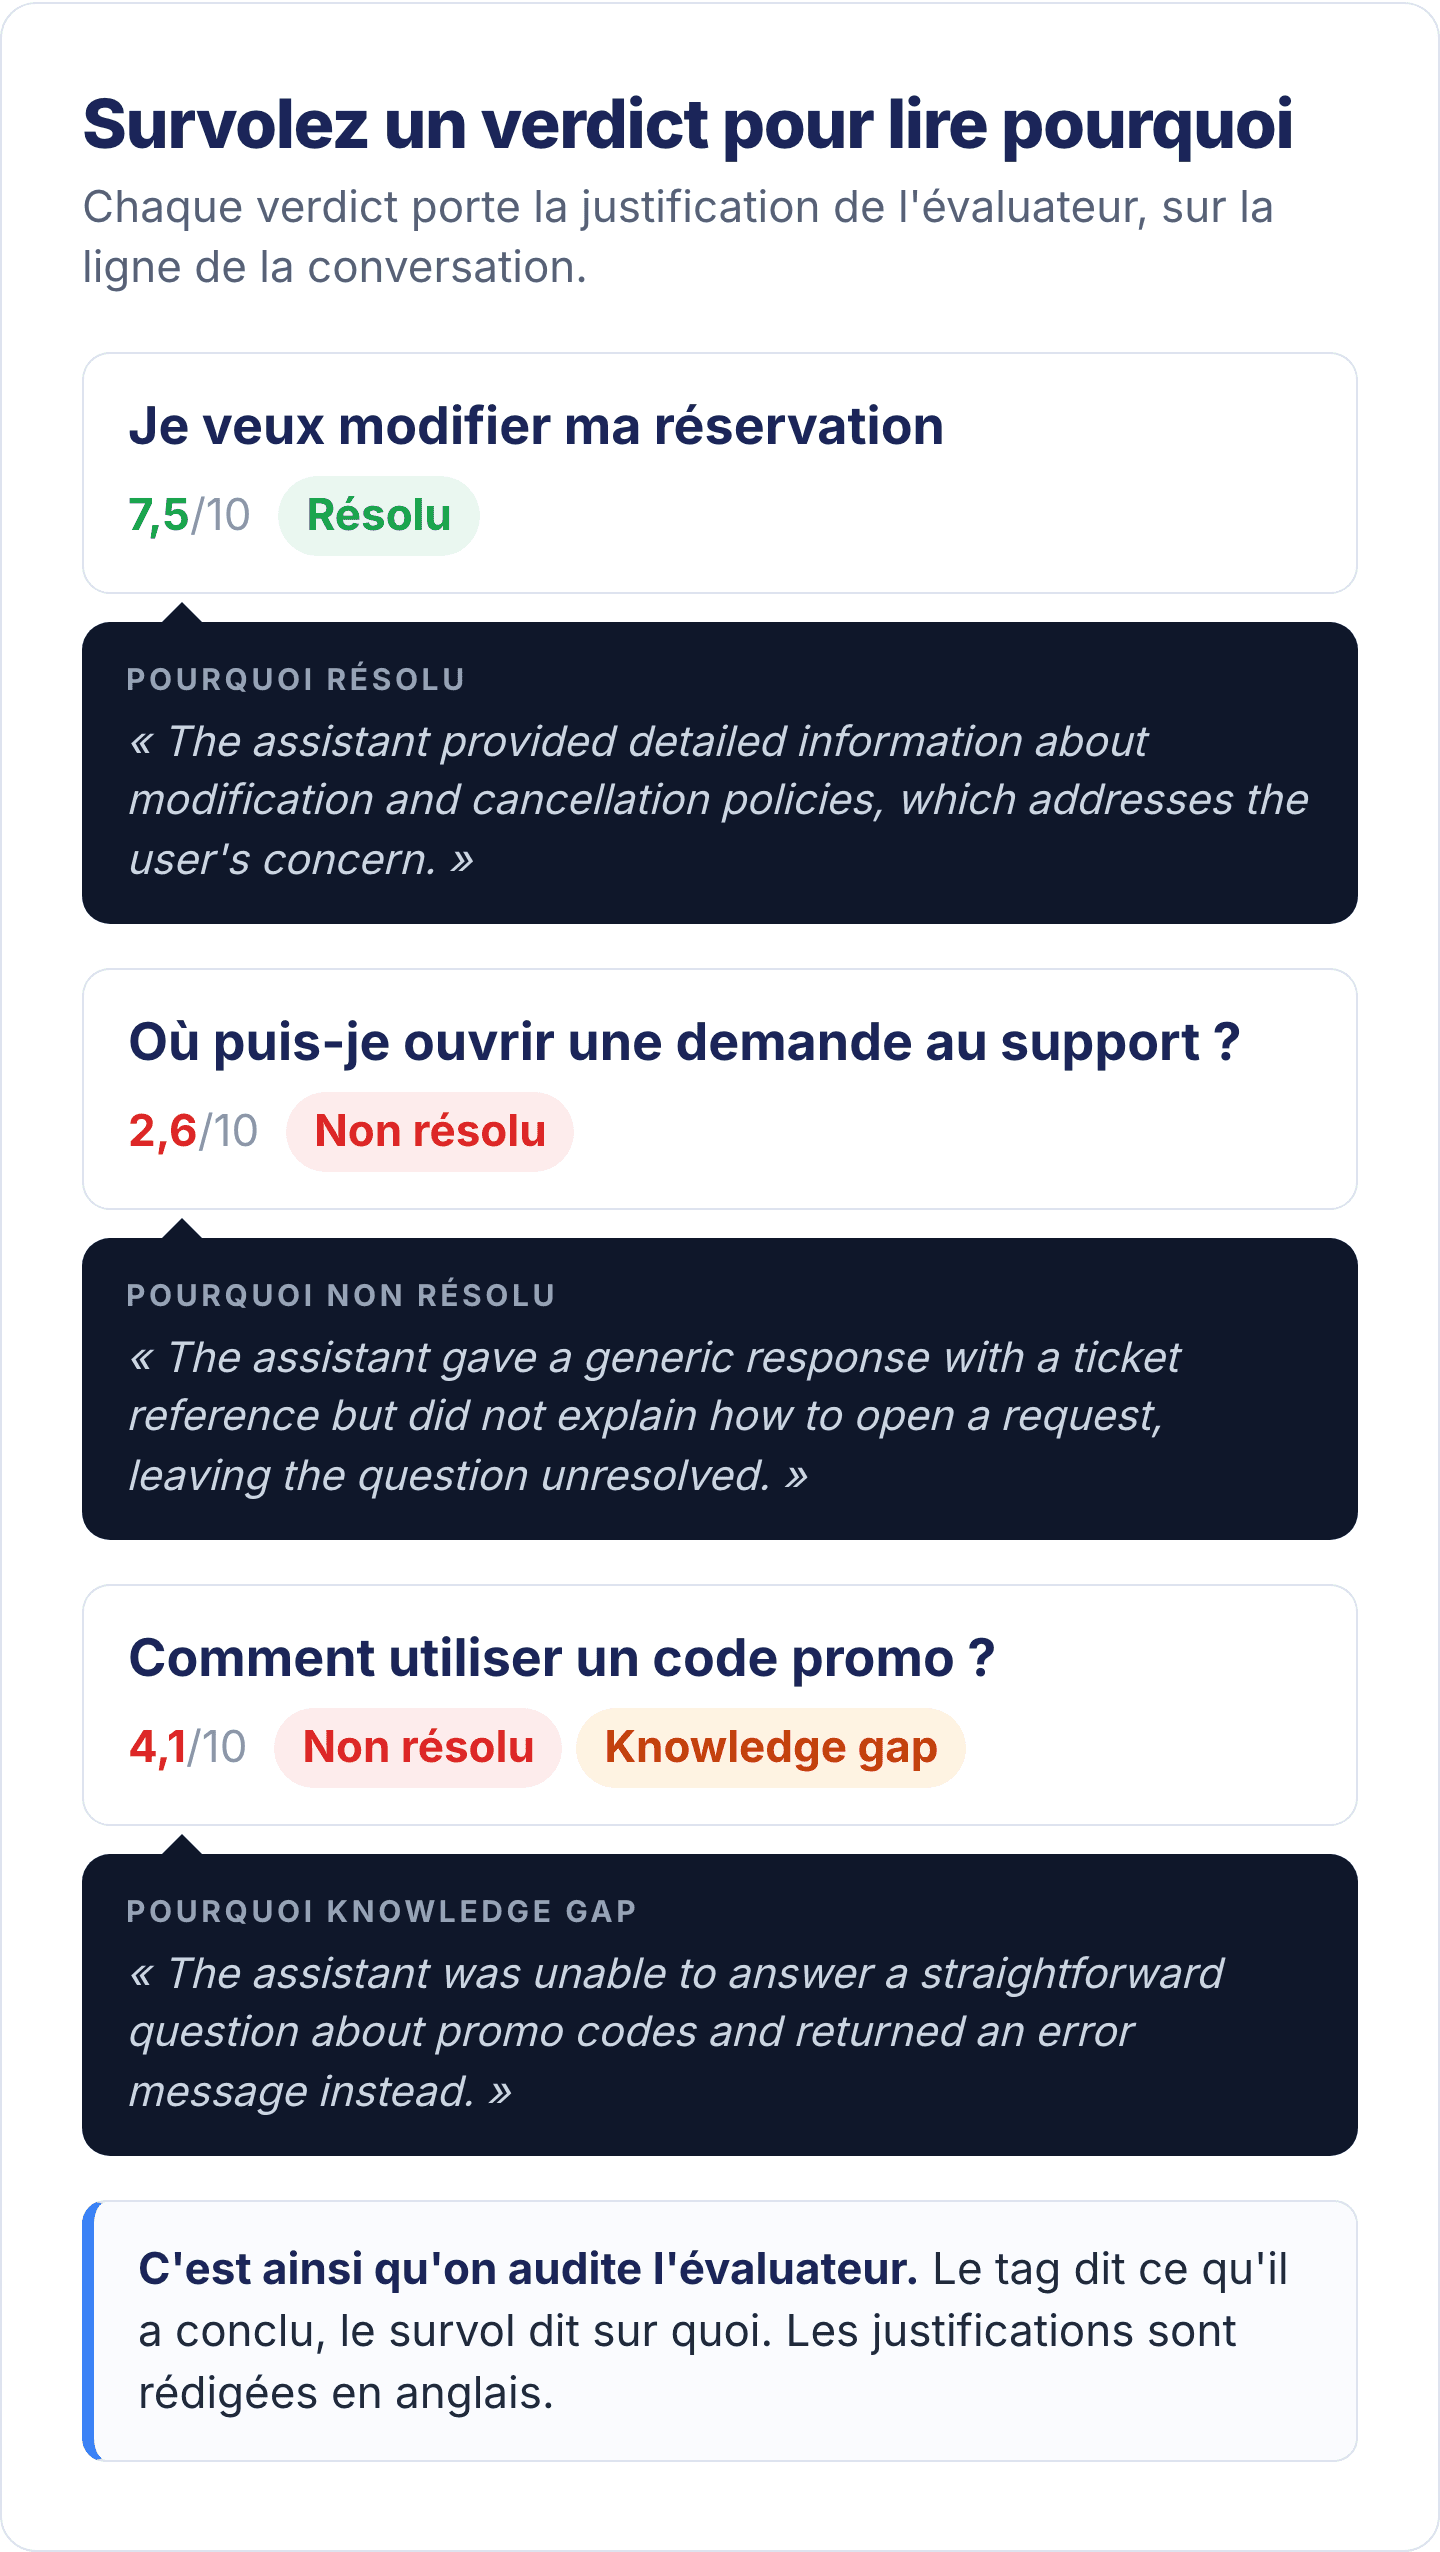
Si vous lisez trois fois « the assistant provided a generic response » et deux fois « did not have the information about », vous savez déjà où vous allez.
Étape 3 : lisez 20 conversations
C'est l'étape que tout le monde saute. C'est aussi la seule qui produit un diagnostic.
Vingt conversations. Un quart d'heure. Pas les justifications de l'IA cette fois : les vrais messages, écrits par vos vrais clients. Vous cherchez un motif, et il rentre presque toujours dans l'une de ces cinq cases.
Ils demandent tous la même chose que le bot n'a pas
Diagnostic : Knowledge gap
Qui corrige : L'équipe qui écrit la base de connaissances
Le bot comprend de travers la question
Diagnostic : Compréhension
Qui corrige : Intentions, exemples, reformulation
Le bot comprend, mais le parcours mène à une impasse
Diagnostic : Conception du flux
Qui corrige : Le bot builder
Ils demandent quelque chose que le bot n'est pas censé traiter
Diagnostic : Périmètre
Qui corrige : Routage vers le bon canal, pas une correction
Le bot a raison, la réponse ne leur plaît pas
Diagnostic : Politique
Qui corrige : Le métier qui possède la règle, pas le bot
La dernière ligne est réelle et fréquente. Parfois, la bonne conclusion est « le bot va bien ». Une politique de remboursement impopulaire, énoncée correctement, produit des conversations non résolues aux yeux du client et un bot qui a fait son travail. Ce n'est pas au bot builder de la changer. Vous ne pouvez atteindre cette conclusion qu'en lisant.
La grille de lecture 20 conversations
Les cinq diagnostics, la question à se poser pour chacun, et qui corrige. Une page, à garder ouverte pendant la lecture.
Étape 4 : corrigez une seule chose
Un sujet. Une cause. Une correction.
Résistez à l'envie de corriger cinq choses en même temps. Si vous changez tout, vous n'apprendrez rien sur ce qui a marché. Et le mois prochain, vous recommencerez de zéro.
Le cas le plus fréquent, et le plus rapide à corriger, est le knowledge gap. Le bot n'avait pas l'information. Un agent IA répond à partir de ce qu'il y a dans la base de connaissances ; si l'information n'y est pas, il ne peut pas la dire.
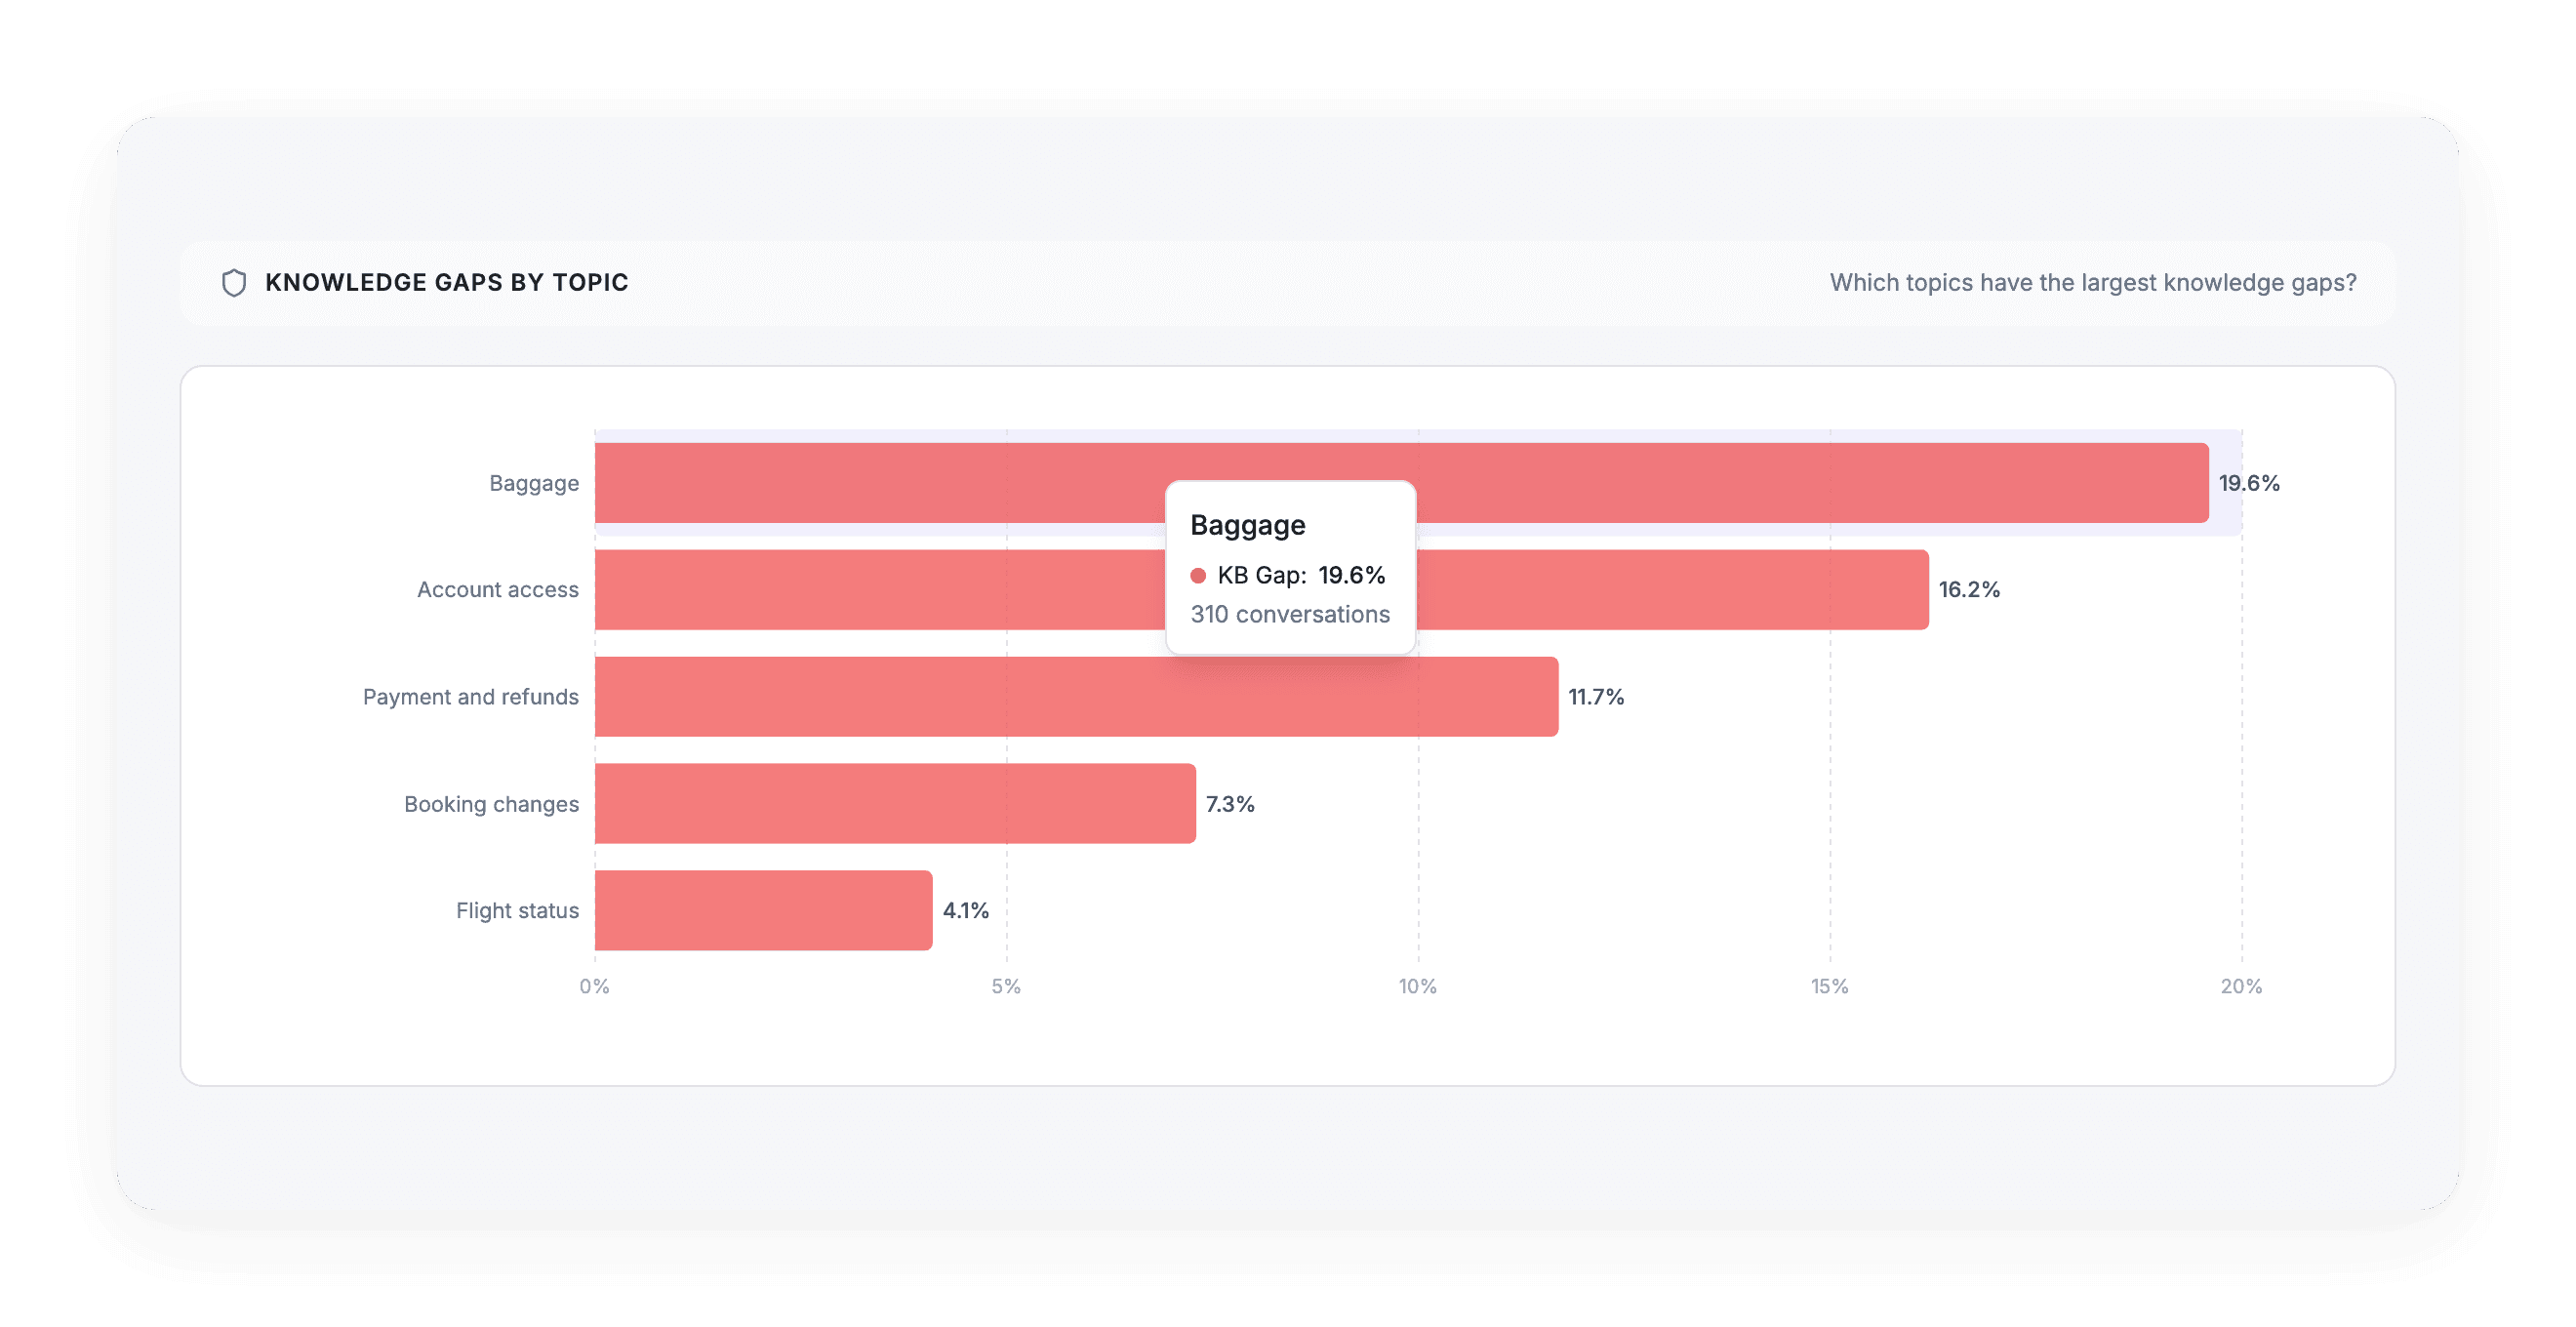
L'onglet Performance montre où les gaps se concentrent, sujet par sujet.
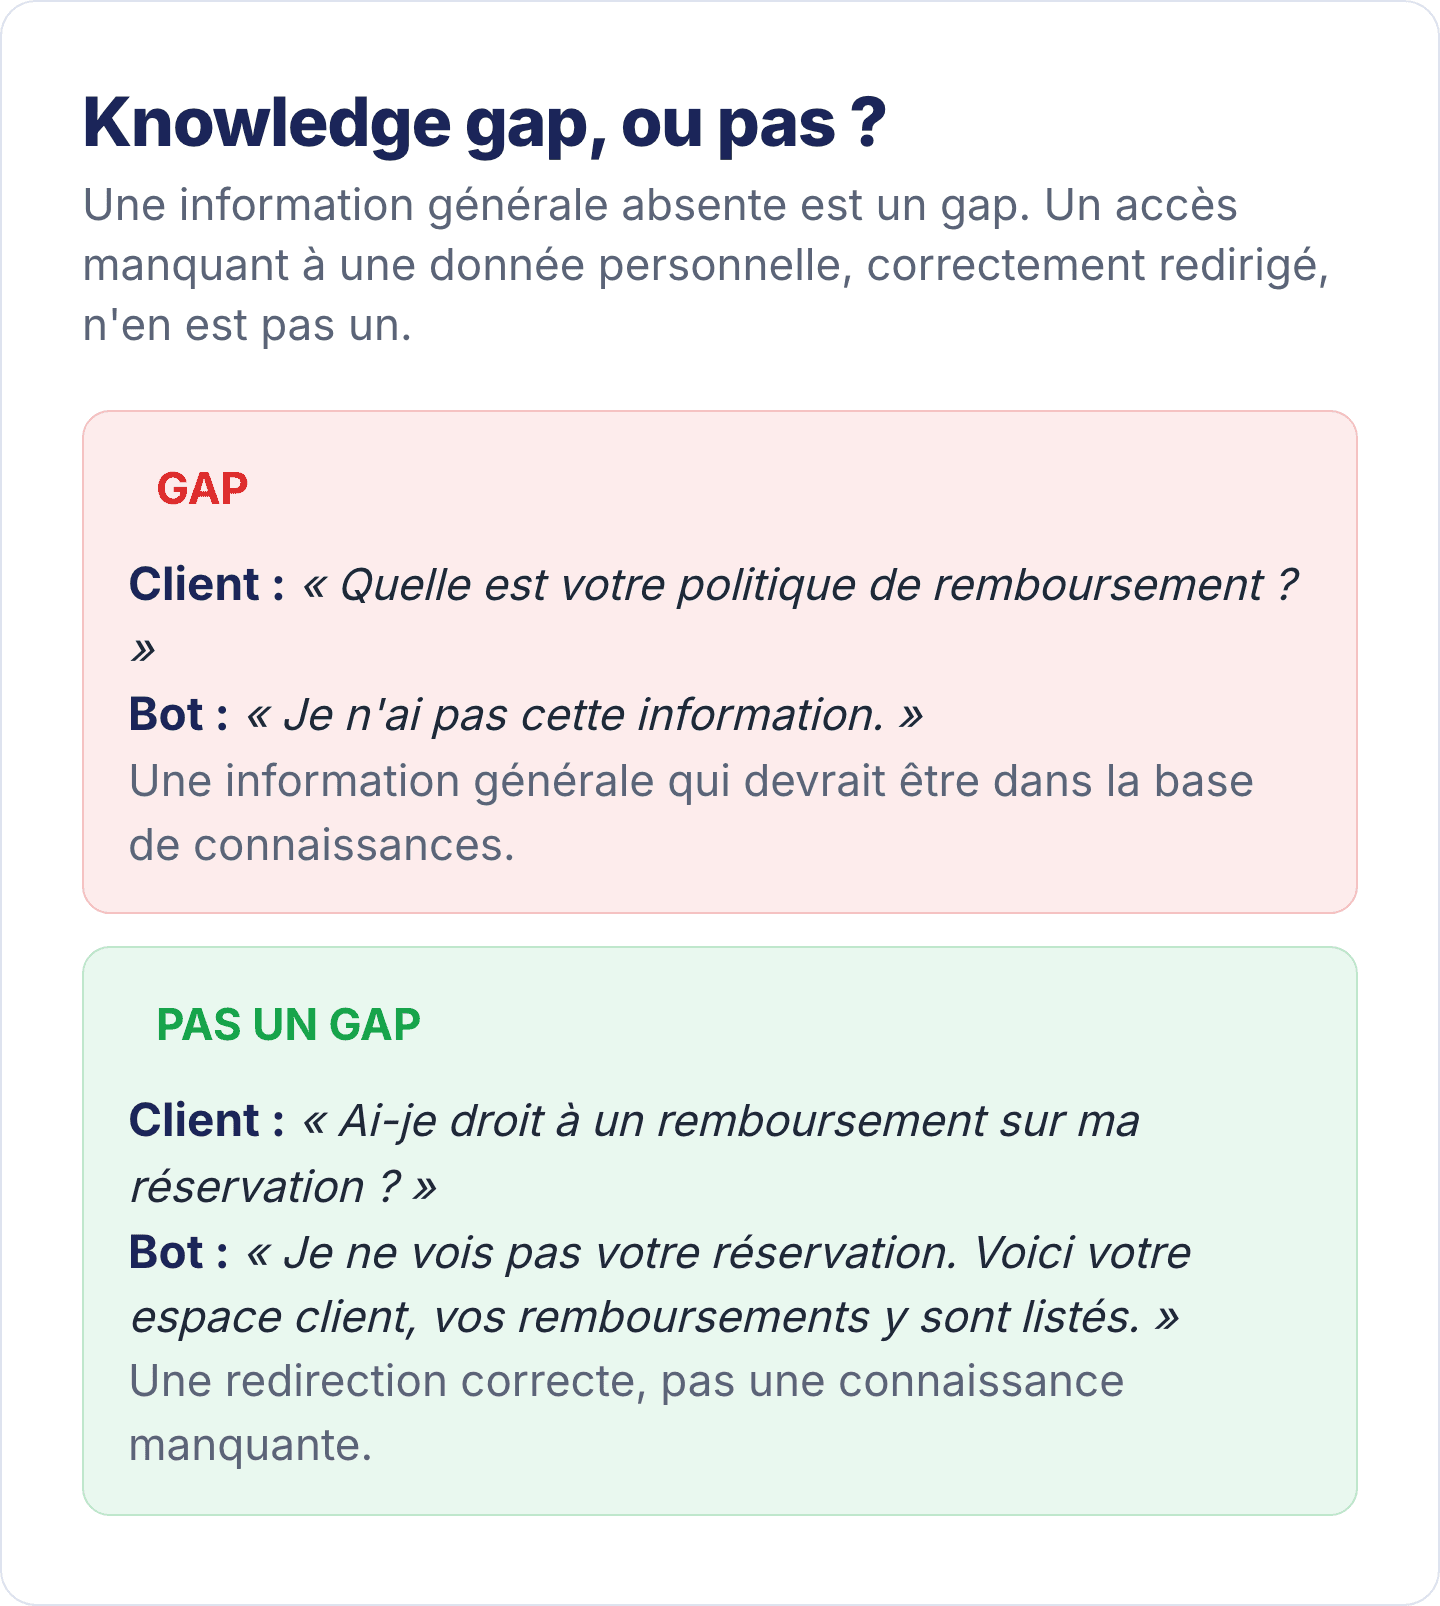
Un point de vocabulaire, parce qu'il évite de fausses corrections. Un knowledge gap, c'est une information générale absente : la politique de remboursement, les dimensions de bagage autorisées, les horaires du service. Ce n'est pas un knowledge gap quand le bot ne peut pas accéder à une donnée personnelle ou en temps réel et redirige correctement l'utilisateur vers l'endroit où elle se trouve. Le bot n'a pas à connaître le solde d'un client. Il doit savoir où le client peut le voir.
Lecture rapide du taux de knowledge gap d'un sujet : sous 15 %, sain. Entre 15 et 30 %, à surveiller. Au-dessus de 30 %, près d'une conversation sur trois bute sur un mur : c'est une urgence de contenu, et une liste d'articles à écrire cette semaine.
Pour les autres diagnostics : une impasse de flux se corrige dans le bot builder, une incompréhension dans les intentions et leurs exemples, une question hors périmètre par un routage. Une seule correction, puis on attend.
Étape 5 : revenez dans trois semaines, sur le même tableau
Retournez sur Unresolved Drivers. Retrouvez la ligne de votre sujet. Son taux de résolution a-t-il bougé ? Son volume ? Son knowledge gap ?
C'est le même tableau, les mêmes critères, la même population. La comparaison est honnête. Si le chiffre a bougé, vous savez pourquoi. S'il n'a pas bougé, vous savez que ce n'était pas la bonne cause, et vous avez déjà 20 conversations de lues pour trouver la suivante.
Trois semaines, parce qu'il faut assez de nouvelles conversations sur le sujet pour que le chiffre veuille dire quelque chose, et parce que l'évaluation se fait après la fin de chaque conversation, par lots, avec un léger décalage.
Puis vous prenez la ligne suivante du tableau. C'est toute la méthode. Pas une refonte : des répétitions de cette boucle, un sujet à la fois.
Voir cette boucle tourner sur vos conversations
Une démo de 30 minutes sur vos sujets, pas sur les nôtres.
Deux pièges classiques
Un gros sujet « Autre », mal résolu. Si « Autre » figure dans vos premiers sujets et se résout mal, votre liste de sujets rate quelque chose de réel. Lisez ces conversations : vous y trouverez un sujet qui n'a pas de nom. Donnez-lui-en un. Dans ViaSay, la découverte automatique de sujets propose régulièrement des candidats, que vous validez ou non.
Résolution basse, knowledge gap bas. Le bot a l'information, et la conversation échoue quand même. Le problème n'est donc pas le contenu. Soit le flux (la réponse existe, l'utilisateur ne l'atteint jamais), soit la réponse est correcte et c'est le service derrière qui déçoit. Dix conversations suffisent à trancher, et dans les deux cas la correction n'est pas dans la base de connaissances.
Où mettre l'IA générative ensuite
Une fois la boucle en place, une deuxième question arrive : sur quels sujets remplacer un parcours scripté par une réponse générée ?
La section AI Impact de l'Overview compare, sur vos conversations, celles gérées par une étape d'IA générative et celles gérées par un parcours scripté : résolution, knowledge gap, CX Score, CSAT. Sur la capture de l'article précédent, l'IA résolvait à 61 % contre 33 % pour le scripté, avec un knowledge gap de 7 % contre 19 %.
Deux précautions de lecture. Ce n'est pas une expérience contrôlée : l'IA n'est pas déployée au hasard, elle est souvent activée sur les sujets déjà faciles, ou déjà difficiles. Et le chiffre global est moins utile que la lecture sujet par sujet : la bonne question n'est pas « l'IA fait-elle mieux ? » mais « sur lesquels de mes sujets change-t-elle le résultat ? ».
Un sujet scripté avec un knowledge gap élevé est en général le premier candidat : l'information manque, et un parcours scripté ne saura jamais la chercher.
Ce qu'il faut retenir
Triez par impact, pas par pourcentage. Impact = Volume × (100 − Résolution). Le sujet qui vous coûte le plus n'est presque jamais celui qui a le pire taux.
Ouvrez les conversations, lisez-en 20. Un quart d'heure. Le motif rentre dans cinq cases : knowledge gap, compréhension, flux, périmètre, politique.
Corrigez une seule chose. Le knowledge gap est le diagnostic le plus fréquent et le plus rapide à corriger : c'est du contenu à écrire.
Remesurez au même endroit, trois semaines plus tard. Même tableau, mêmes critères. Puis ligne suivante.
Un taux qui monte à côté d'un volume qui ne bouge pas est la preuve que vous améliorez le bot, et non la façon de compter.
Questions fréquentes
Combien de temps faut-il pour améliorer le taux de résolution d'un chatbot ? Une boucle complète prend environ une heure de travail et trois semaines d'attente. Les premiers points de résolution arrivent dès la première correction si elle porte sur un sujet à fort volume. Les bots qui répètent cette boucle chaque mois se situent en haut de la fourchette observée en production, entre 50 et 85 % de résolution mesurée.
Faut-il refaire le bot pour améliorer son taux de résolution ? Presque jamais. La majorité des conversations non résolues se concentrent sur quelques sujets, et la cause la plus fréquente est une information absente de la base de connaissances. Corriger le contenu d'un sujet à fort volume rapporte plus qu'une refonte.
Qu'est-ce qu'un knowledge gap dans un chatbot ? Une conversation où le bot n'avait pas l'information générale demandée (une politique, un tarif, une procédure). Une redirection correcte vers une donnée personnelle ou en temps réel, comme un espace client, n'est pas un knowledge gap. Le taux de knowledge gap d'un sujet indique directement le contenu à écrire.
Pourquoi lire les conversations si une IA les a déjà évaluées ? L'évaluateur dit qu'une conversation a échoué et donne une raison en une phrase. La lecture de 20 conversations révèle le motif commun, et distingue un problème de contenu d'un problème de flux, de périmètre ou de politique. C'est ce qui décide qui corrige, et quoi.
Faut-il remplacer les parcours scriptés par de l'IA générative ? Sujet par sujet, en regardant la comparaison sur vos propres conversations. Un sujet scripté à fort knowledge gap est en général le meilleur candidat. Un sujet scripté qui résout bien n'a pas de raison de changer.
