

🚀
GUIDE GRATUIT
RFP Chatbot : Ne partez pas d'une page blanche
Un mode d'emploi pensé pour les métiers avec un guide pas à pas pour rédiger chaque section de votre appel d'offres.
Méthodologie guidée : Quoi écrire dans chaque chapitre (Contexte, Fonctionnel, Tech)
Concepts clés décryptés : RAG, LLM, Base de connaissance
Modèles inclus : Structures prêtes à l'emploi pour vos cas d'usage
👉 Télécharger le guide
Dans un appel d'offres chatbot, le taux de résolution des éditeurs n'est comparable que si vous imposez sa définition et vérifiez leur méthode de mesure. Un éditeur annonce 95 %, un autre 80 %, un troisième 55 %, et le comité de sélection note le premier sans savoir comment chacun a compté. Voici douze questions à poser aux éditeurs, une grille pour noter leurs réponses et une clause prête à coller dans votre cahier des charges.
La plupart des cahiers des charges décrivent très bien ce que le chatbot doit faire, et presque jamais comment on saura s'il le fait. Notre guide pour rédiger un appel d'offres chatbot IA détaille les six blocs d'un bon CCTP (cahier des clauses techniques particulières). Cet article ajoute le septième : la mesure de la qualité.
L'essentiel
Un taux de résolution sans définition ne se compare pas : imposez la vôtre dans le CCTP et faites répondre tous les candidats avec elle.
Douze questions en quatre thèmes vérifient la méthode de chaque éditeur. Notées sur 24, elles pèsent 15 % de la note globale.
En soutenance, faites afficher les conversations non résolues et justifier une conversation « résolue » prise au hasard.
Un taux garanti par contrat pousse l'éditeur vers la définition la plus généreuse : exigez plutôt la méthode de mesure.
Avec une définition stricte, les clients de ViaSay en production se situent entre 50 et 85 % de résolution.
Un même chatbot peut afficher 95 %, 80 % ou 55 % selon la définition retenue
Trois définitions du taux de résolution circulent sous le même nom : la déflexion, l'automatisation et la résolution vérifiée. Appliquées aux mêmes conversations d'un même chatbot, elles donnent trois chiffres différents. Deux offres ne se comparent donc qu'à définition égale.
La déflexion compte comme résolue toute conversation qui n'a pas atteint un humain, abandons compris. Ordre de grandeur : 80 à 95 %.
L'automatisation (en anglais, containment) compte toute conversation restée dans le bot, sans transfert. Ordre de grandeur : 80 à 95 %.
La résolution vérifiée ne compte que les conversations où la demande a été traitée, ce que confirme une relecture. Ordre de grandeur : 40 à 85 %.
Le dénominateur, c'est-à-dire les conversations retenues pour le calcul, fait aussi varier le chiffre.
Le marché bascule vers la troisième définition. Intercom a changé son calcul en juillet 2026 : sur son exemple officiel, le même bot passe de 33 % à 50 % en retirant du dénominateur les conversations où il n'a pas eu l'occasion de répondre. Zendesk ne compte plus, depuis mai 2026, que des « Verified Resolutions » confirmées par un modèle de langage.
Un éditeur qui annonce 95 % sans préciser sa définition vous donne, dans la quasi-totalité des cas, un taux d'automatisation. Ce chiffre n'est pas mensonger, mais il mesure autre chose que la résolution.
Les trois définitions sont détaillées dans notre article sur la mesure du taux de résolution d'un chatbot IA. Dans votre consultation, imposez une définition et faites répondre chaque éditeur avec elle.
Dans un appel d'offres chatbot, quelles questions poser sur le taux de résolution ?
Douze questions permettent de vérifier comment un éditeur mesure le taux de résolution qu'il annonce. Elles couvrent quatre thèmes : la définition, la couverture, l'auditabilité (la possibilité de vérifier chaque chiffre) et l'amélioration. Pour chaque question, voici la réponse à attendre et le signal qui doit vous alerter.
La définition (questions 1 à 4)
1. Comment définissez-vous une conversation « résolue » ?
Réponse attendue : une définition écrite, avec des critères : réponse directe, redirection valide, escalade correctement gérée vers un conseiller.
Signal d'alerte : « Une conversation sans transfert vers un agent. »
2. Une escalade vers un conseiller compte-t-elle comme un échec ?
Réponse attendue : non, si elle est correcte : le bot a identifié sa limite et transféré proprement. Oui, s'il a refusé sans alternative, transféré une question qu'il savait traiter, ou seulement dit qu'aucun conseiller n'était disponible.
Signal d'alerte : toute escalade vaut échec, ce qui pousse le bot à retenir le client, ou toute escalade vaut succès, ce qui gonfle le chiffre.
3. Qu'est-ce qui sort du dénominateur ?
Réponse attendue : les conversations sans demande exprimée, ou celles où le bot n'a pas eu l'occasion de répondre. Le taux d'automatisation reste calculé sur le total, pour contrôle.
Signal d'alerte : rien ne sort, et le chiffre mesure alors aussi la disponibilité des utilisateurs ; ou tout sort, sans contrepoids.
4. Le silence du client après la dernière réponse compte-t-il comme une résolution ?
Réponse attendue : jamais par défaut. L'évaluation porte sur ce qui a été donné au client avant son départ, et un départ pendant une étape en attente (question, identifiant, choix) est mis à part.
Signal d'alerte : « Pas de nouvelle question, donc résolu. »
La couverture (questions 5 à 7)
5. Quelle part des conversations est évaluée ?
Réponse attendue : 100 % des conversations terminées.
Signal d'alerte : un échantillon, ou seulement les conversations où le client a voté.
6. Les parcours scriptés, écrits à l'avance, sont-ils évalués comme les réponses générées par l'IA ?
Réponse attendue : oui, avec les mêmes critères, et une comparaison des deux.
Signal d'alerte : seules les réponses de l'IA générative sont mesurées.
7. Qui rend le verdict ?
Réponse attendue : un évaluateur IA distinct du bot, avec une grille de critères fixe, complété par des votes de clients réels.
Signal d'alerte : le bot s'évalue lui-même, ou un humain relit 2 % des conversations.
L'auditabilité (questions 8 à 10)
8. Puis-je ouvrir les conversations derrière chaque chiffre ?
Réponse attendue : oui, depuis n'importe quel indicateur, avec les conversations déjà filtrées.
Signal d'alerte : le taux n'est qu'un chiffre dans un rapport mensuel.
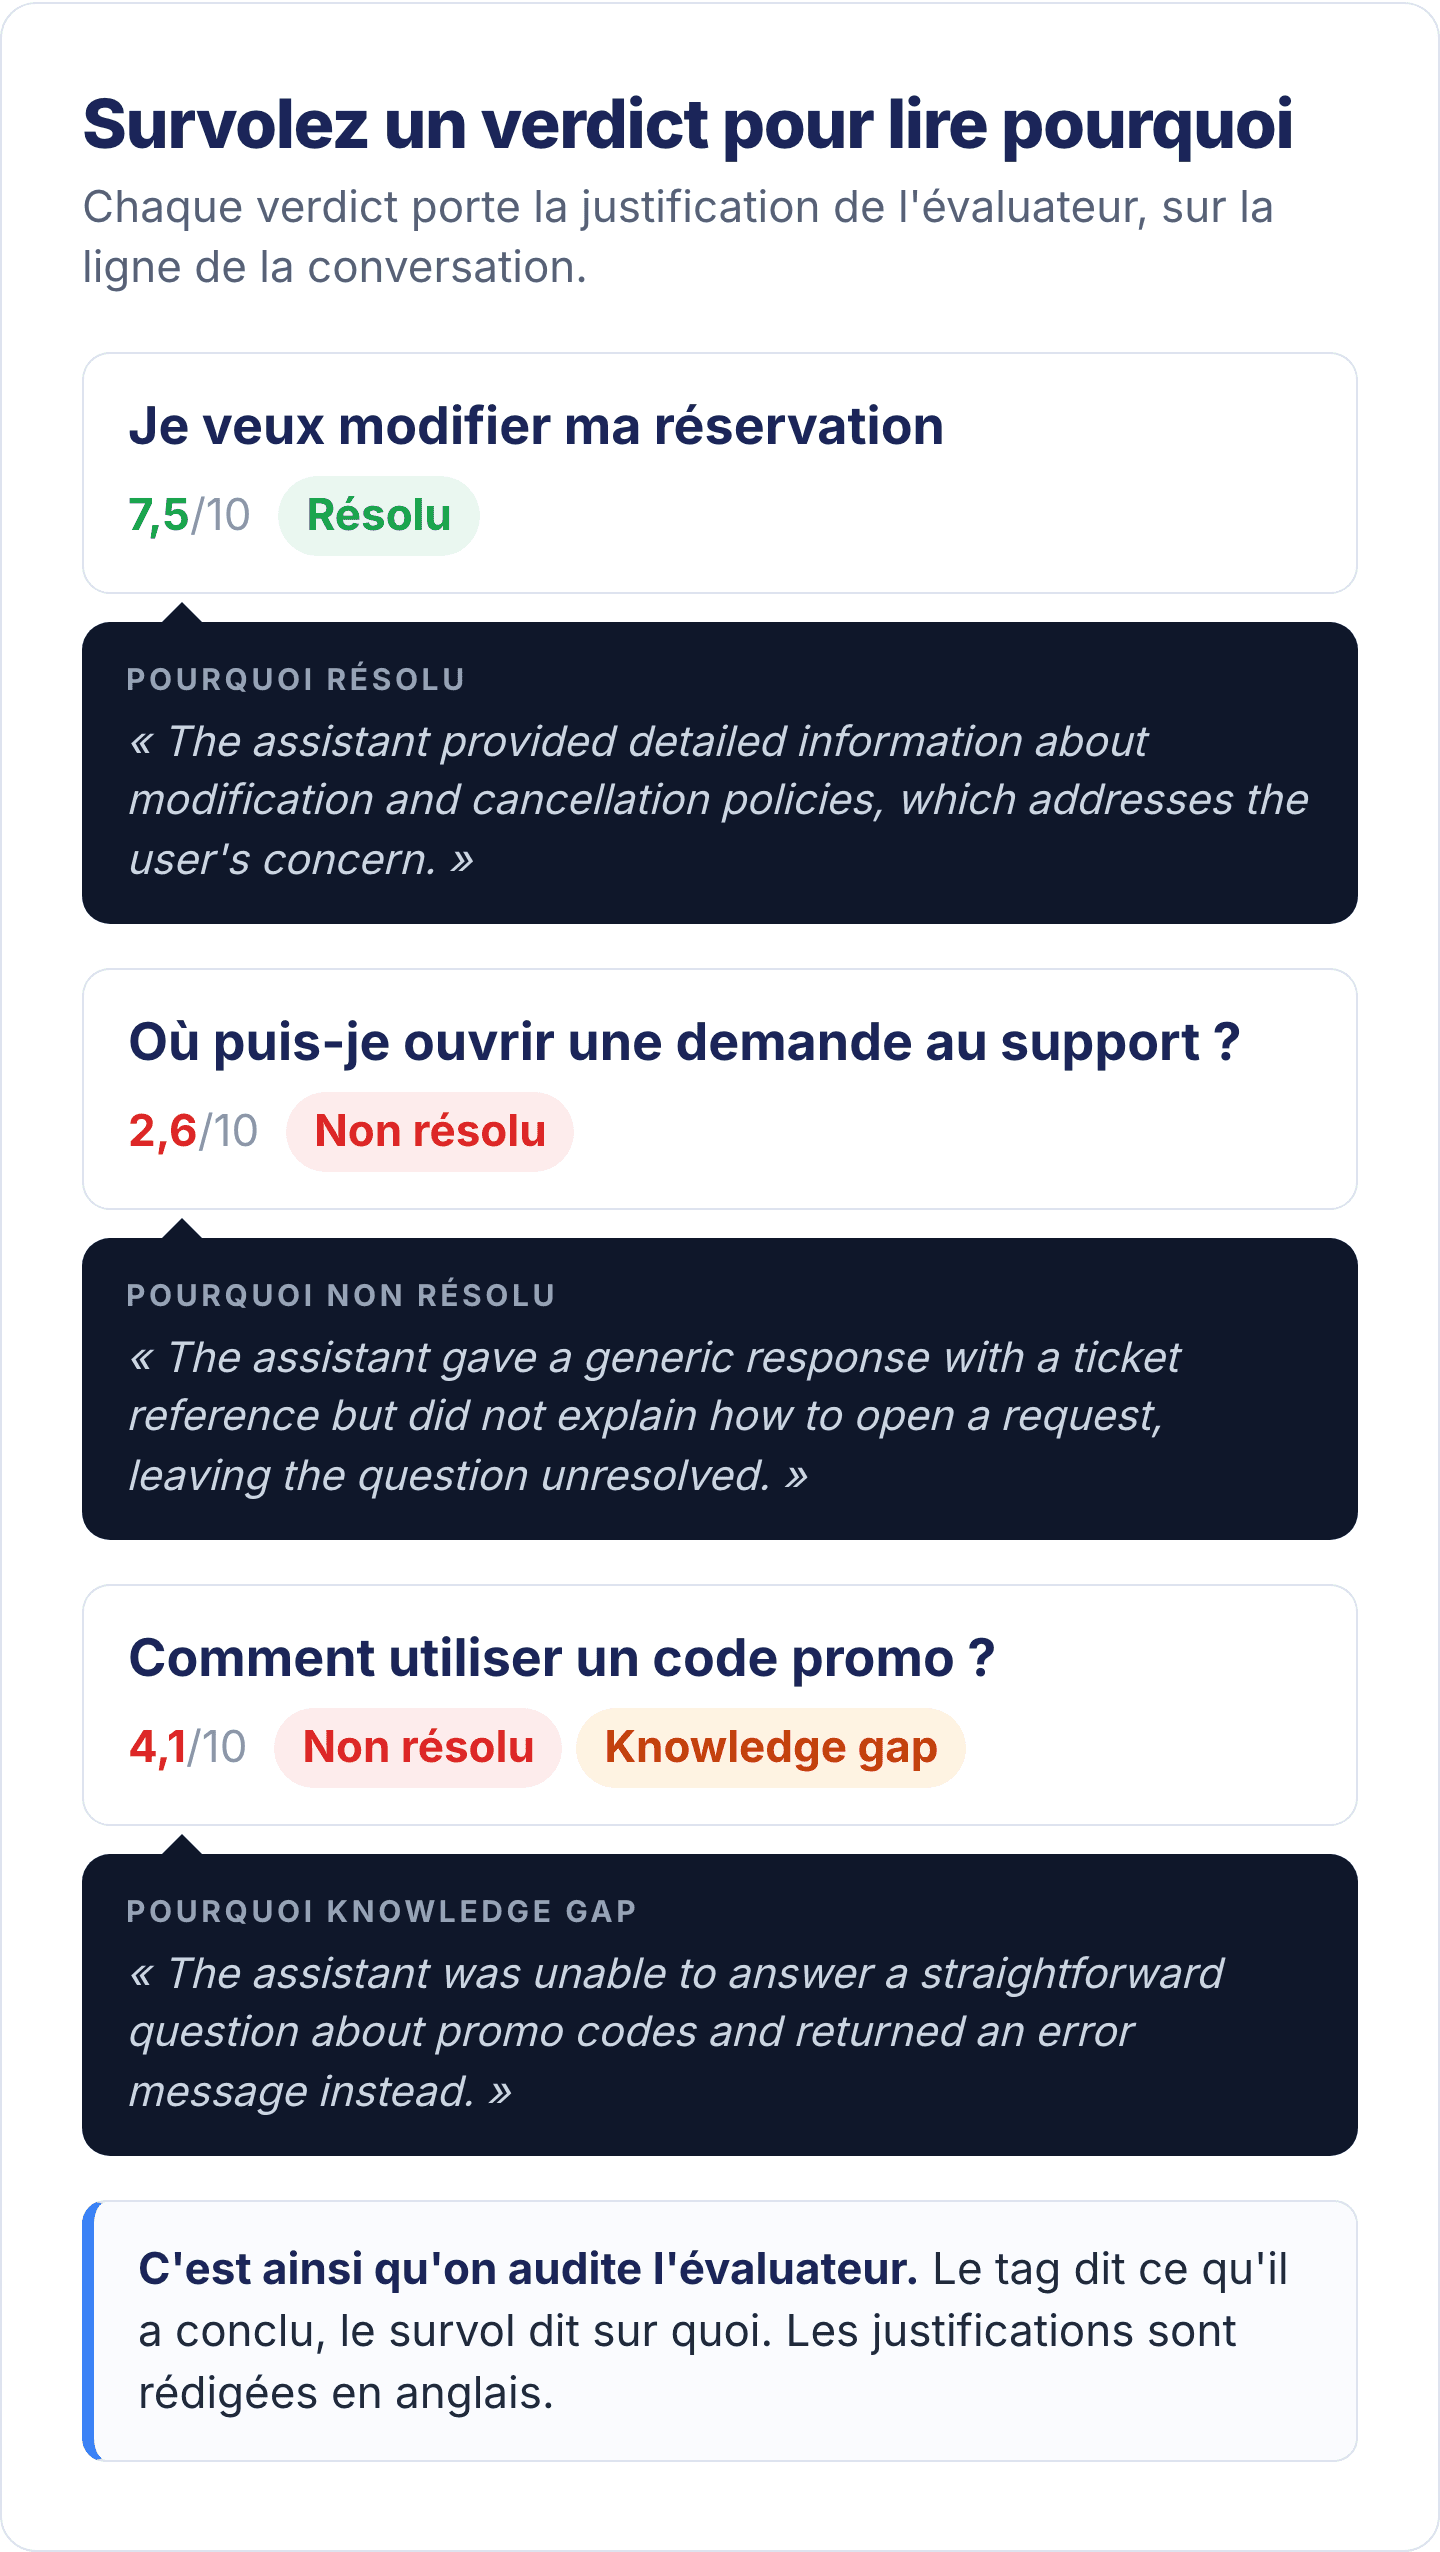
9. Chaque verdict est-il justifié ?
Réponse attendue : oui. L'évaluateur explique en une phrase pourquoi il a jugé la conversation résolue, non résolue ou en manque d'information.
Signal d'alerte : un pourcentage, sans explication pour chaque conversation.
10. Le taux indique-t-il pourquoi une conversation a échoué ?
Réponse attendue : oui, en distinguant le manque d'information dans la base de connaissances (en anglais, knowledge gap), l'incompréhension et l'impasse de parcours.
Signal d'alerte : un seul chiffre global, sans cause.
L'amélioration (questions 11 et 12)
11. Comment passe-t-on du chiffre à une correction ?
Réponse attendue : un classement des sujets par nombre de conversations perdues (volume × non-résolu), et non par pourcentage. Chaque sujet renvoie directement au contenu ou au parcours à corriger.
Signal d'alerte : « Votre CSM vous fera un rapport », le CSM étant le responsable du suivi client chez l'éditeur.
12. Quel taux vos clients en production atteignent-ils avec cette définition ?
Réponse attendue : une fourchette honnête, mesurée avec la définition de la question 1.
Signal d'alerte : un chiffre unique, rond, supérieur à 90 %.
Chez ViaSay, nous répondons à la question 12 par une fourchette : entre 50 et 85 % selon le client. Ce taux est mesuré conversation par conversation par un évaluateur IA, escalades correctes comprises.
Le bas de la fourchette correspond aux chatbots que nous venons de commencer à mesurer. Le haut correspond à ceux sur lesquels un sujet est corrigé chaque mois depuis un an.
Pour les questions 8 et 9, « auditable » signifie que chaque conversation porte son verdict, dont le survol affiche la raison.
Une grille sur 24 points permet de noter les réponses des éditeurs
Chaque question se note de 0 à 2 points, soit un total sur 24, compatible avec les grilles de sélection pondérées habituelles. Nous recommandons de donner à ce bloc « mesure de la qualité » 15 % de la note globale, autant qu'aux intégrations. C'est lui qui vous dira, six mois après la mise en production, si le projet tient ses promesses.
0 point : pas de réponse, ou un signal d'alerte.
1 point : une réponse partielle, ou une promesse sans démonstration.
2 points : une réponse complète, démontrée en soutenance sur des conversations réelles.
En soutenance (la présentation orale des candidats), deux tests sont particulièrement révélateurs.
Demandez à voir le taux de résolution mesuré sur la démo, et pas seulement la démo. Un éditeur qui mesure vraiment montrera sans hésiter l'écran des conversations non résolues ; les autres montreront un bot qui répond bien.
Faites ouvrir une conversation « résolue » prise au hasard, puis demandez pourquoi elle est comptée comme résolue. La réponse, ou son absence, vous en apprendra autant que les douze questions.
Une clause du cahier des charges fixe la définition et la méthode de mesure
La clause ci-dessous inscrit dans le CCTP la définition de la résolution, la couverture de 100 % des conversations et l'accès à chaque verdict. Collez-la dans le bloc « Exigences fonctionnelles » ou « Pilotage et reporting » : tous les candidats répondront alors avec la même définition.
Mesure de la qualité des conversations. Le titulaire fournit un taux de résolution calculé sur 100 % des conversations terminées, parcours scriptés et réponses générées inclus.
Une conversation est comptée résolue lorsque la demande exprimée par l'utilisateur a été traitée : réponse directe, redirection vers une ressource valide, ou escalade correctement gérée vers un conseiller. Le silence de l'utilisateur ne vaut pas résolution.
Chaque verdict est consultable individuellement, avec sa justification, depuis le tableau de bord. Le titulaire distingue les conversations non résolues par manque d'information dans la base de connaissances de celles non résolues pour une autre cause. Le taux d'automatisation est fourni séparément et calculé sur le total des conversations.
Ajoutez aussi cette exigence à la liste des pièces à fournir :
« Le candidat indique le taux de résolution atteint par trois clients en production, avec la définition ci-dessus, et précise la méthode d'évaluation. »
Le modèle Excel de grille de sélection, fourni avec notre guide RGPD et appel d'offres chatbot IA, accueille ce bloc dans un onglet supplémentaire.
Un taux de résolution garanti par contrat produit presque toujours l'effet inverse
Certains cahiers des charges exigent un taux de résolution contractuel, par exemple « 80 % minimum, pénalités au-delà ». L'intention est bonne, mais l'effet est presque toujours inverse : l'éditeur choisit la définition qui lui donne ce chiffre, et le bot apprend à éviter les escalades.
Vous obtenez alors un taux d'automatisation de 90 % garanti, sans moyen de savoir combien de clients sont partis sans réponse. Et un bot poussé à « tenir le chiffre » évite de passer la main à un conseiller, ce qui est exactement ce que vos clients détestent.
Exigez la méthode de mesure plutôt que le résultat : une définition stricte, une couverture de 100 %, des verdicts auditables et une revue trimestrielle du taux sur cette base. Quand le chiffre se lit conversation par conversation, il progresse de lui-même.
Voir ce que « mesuré » veut dire, sur une vraie instance
Une démo de 30 minutes de l'AI Quality Monitoring, avec l'écran des conversations non résolues et la justification de chaque verdict.
Questions fréquentes
Quel taux de résolution demander dans un appel d'offres chatbot IA ? Il vaut mieux n'imposer aucun chiffre. Demandez une définition stricte (demande traitée, escalade correcte comprise, silence non compté), une couverture de 100 % des conversations et des verdicts auditables. Avec cette définition, une fourchette de 50 à 85 % est crédible ; un chiffre supérieur à 90 % mesure presque toujours autre chose.
Quelle différence entre taux d'automatisation et taux de résolution dans un cahier des charges ? Le taux d'automatisation compte les conversations restées dans le bot sans transfert ; le taux de résolution, celles où la demande a été traitée. Demandez les deux, le premier calculé sur le total des conversations.
Faut-il exiger un taux de résolution contractuel avec pénalités ? Non. L'éditeur choisirait la définition la plus généreuse et réglerait le bot pour éviter les escalades. Exigez plutôt la méthode de mesure et une revue trimestrielle du taux.
Comment vérifier en soutenance qu'un éditeur mesure vraiment la résolution ? Demandez l'écran des conversations non résolues de la démo, puis faites ouvrir une conversation comptée comme résolue et demandez pourquoi elle l'est.
Les parcours scriptés doivent-ils être évalués comme les réponses de l'IA générative ? Oui, avec les mêmes critères. C'est la seule façon de comparer les deux sur vos propres sujets, et de décider où déployer l'IA générative ensuite.
